서울 6,394칸을 하룻밤에 칠하기: HypeSeoul 기술 회고
코드 조각은 실제 코드에서 뽑았고, 줄인 것은 "(요약)"이라고 적었다.
한 줄 요약
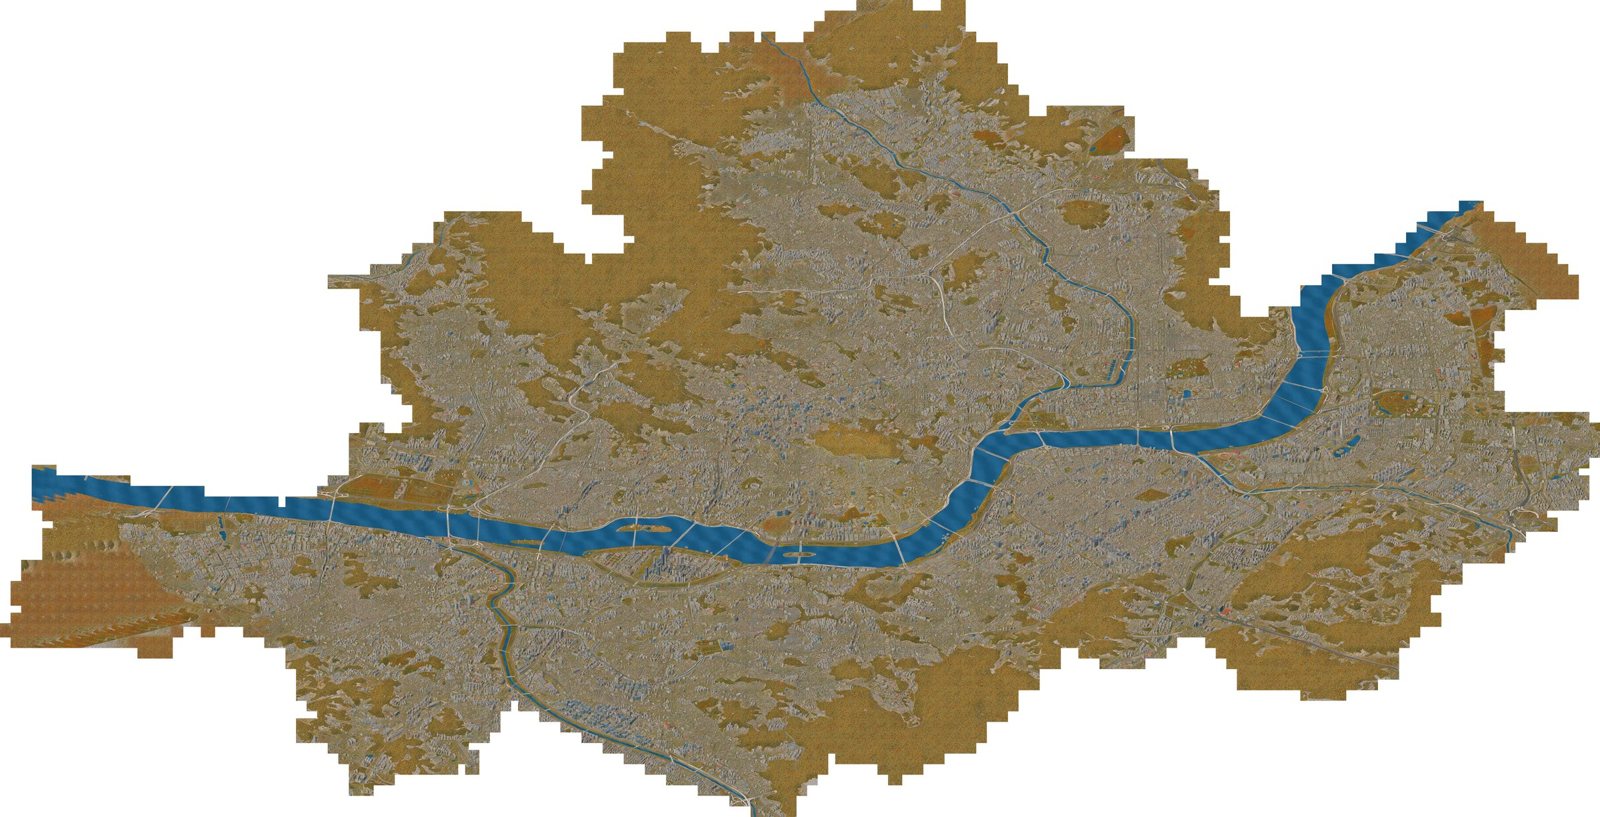
실제 지도 데이터로 서울을 3D로 세우고, 우리 그림체를 학습한 이미지 모델로 그 화면을 칸마다 다시 칠한 뒤, 그 위에 차·지하철·배·사람·행사·낮밤이 돌아가는 살아 있는 층을 얹었다. 지하철 일부(1·2·3호선, 경의중앙선)는 서울시 실제 운행 데이터로 움직인다. 그게 hypeseoul.xyz다.
왜 만들었나
이것저것 보다가 우연히 뉴욕 지도 하나를 봤다. 위성지도를 바탕으로 뉴욕 전체를 아이소메트릭 픽셀아트처럼 다시 그린, Andy Coenen의 isometric.nyc다. 실제 지형을 렌더하고, 파인튜닝한 이미지 모델로 칸마다 다시 그리는 방식이다.
서울 버전의 기준은 단순했다. 서울 항공뷰를 바탕으로 서울을 재현하되, 한강과 랜드마크가 보여야 했다. 그리고 하나가 더 걸렸다. 뉴욕 지도는 멋있지만 움직이는 차나 사람이 없어서 재미는 좀 없었다.
HypeSeoul은 이 영감을 받아 독립적으로 만든 프로젝트다. 원작자와의 공식 협업이나 제휴는 없다. 원작의 공개 제작기에서 방법(3D로 렌더한 화면을 이미지 편집 모델로 다시 칠하기, 학습 쌍 규모)을 참고했고, 원작 코드는 한 줄도 가져오지 않았다. 엔진·학습·타일 도구는 전부 새로 짰다. 우리가 더하고 싶었던 건 세 가지였다. 그림 밑에 픽셀 단위로 맞춰진 3D 서울, 그 위에서 움직이는 도시, 그리고 서울 시간에 맞춰 바뀌는 낮과 밤. 하다 보니 지도가 원래 사이트보다 커졌고, 결국 지도가 서비스 자체가 됐다.
전체 구조
오프라인 파이프라인
 OSM(건물·도로·물·공원) ┐
 Overture Maps(빠진 건물) ├─ bake ─> seoul.bin (건물 약 58.5만, 지형, 토지이용 지도)
 국토부 GIS건물통합정보(층수) │
 DEM(지형)               ┘
            │
            v
 three.js 엔진 ── Playwright로 1024×1024 칸 촬영 (0.3 m/px, 칸 간격 768px, 겹침 256px)
            │
            v
 FLUX.2 klein base 4B + 편집 LoRA (Modal A100 ×10, 8스텝, guidance 1)
            │
            v
 water_qa → water_fix → forest_grade → harmonize → shade        (자동 보정 체인)
            │
            ├── 랜드마크·다리·주차장 패치 (GPT로 그 자리만 다시 그림 → ECC 정합)
            v
 build_pyramid: 768px RGBA WebP, z0~8, 서울 경계로 알파
            │                         lights.py: 엔진 건물 데이터 → 불빛 피라미드
            v                                  │
 정적 스토리지(R2) <────────────────────────────┘
            │
            v
 브라우저: paint.mjs가 타일을 받아 엔진 화면 위에 합성
모든 것을 묶는 것: 같은 카메라
엔진 카메라는 정사영(orthographic)에 각도가 고정이다(yaw −0.42, pitch 0.56 rad). 그래서 그림 한 장은 화면에서 평행 이동과 확대만 한다. 세계 좌표(x, z, 높이 y)에서 그림 픽셀로 가는 변환이 아핀 하나로 끝난다. 0.3 m/px에서 브라우저로 직접 잰 값이다.
// engine/preview.mjs — 캔버스 px = anchorPx + AX·dx + AZ·dz + AY·dy (미터당 px)
const AX = [3.0436, -.7220], AZ = [1.3592, 1.6167], AY = [0, -2.8242], Y0 = 18.8516, REF = .3;
같은 상수가 Python 쪽(lm_prep, lights, shade, build_pyramid)에도 그대로 들어 있다. 엔진 물 픽셀로 그림의 물을 검사하고, OSM 건물 외곽선을 그림 위에 빨갛게 투영하고, 엔진 건물로 창문 불빛을 계산하고, 차가 그림 속 도로를 달리는 것이 전부 이 행렬 하나로 된다. 이 글의 거의 모든 해결책은 "같은 카메라"를 지킨 덕분에 가능했다.
프레임마다 도는 패스
engine/scene.mjs의 render()는 이 순서다.
function render() {
  scene.background.copy(bgDay).lerp(bgNight, U.uNight.value);
  applyView();
  renderShadow();                                        // 1. 해 그림자 맵
  renderer.setRenderTarget(rt); renderer.render(scene, cam);   // 2. 저해상도 본 패스(+깊이)
  placePainting();                                       // 3. 그림 타일 → 4. 움직이는 것 마스크
  renderGlow();                                          // 5. 빛 효과(가산)
  renderer.setRenderTarget(null); renderer.render(postScene, postCam);   // 6. 후처리 합성
}
 shadowRT (4096², 폰 2048²) ─┐
 rt: 저해상도 색+깊이 ───────┼─> POST: 깊이 외곽선 → AO → 밤 번짐 → 색 보정
 paint.rt: 그림 타일(기기 해상도) ┤        → 그림 합성 mix(c, paint, a·(1−mask))
 rtMove: 움직이는 것 마스크 ──┤        → + glow
 rtGlow: 빛 효과(레이어 2) ────┘
- 본 패스: 화면 크기를
pixel(기본 2)로 나눈 렌더 타깃에 그리고, Nearest 필터로 늘린다. 픽셀아트 느낌은 여기서 나온다. 깊이는 FloatType DepthTexture로 받아서 다음 패스들이 공유한다. - 그림자: 그림자 카메라를 매 프레임 화면에 보이는 땅(네 모서리 + 위로 420m)에 맞추고, 중심을 텍셀 단위로 반올림한다.
- 외곽선: 깊이의 2차 차분을 쓴다. 평면 위에서는 기울기와 상관없이 0이고, 실루엣에서만 커진다. 임계값은 줌에 따라
max(3, mpp × pixel × 2.4).
// POST_FS (발췌)
float l = lin(texture2D(tDepth, vUv - vec2(px.x, 0.0)).r), r = lin(texture2D(tDepth, vUv + vec2(px.x, 0.0)).r);
float u = lin(texture2D(tDepth, vUv - vec2(0.0, px.y)).r), dn = lin(texture2D(tDepth, vUv + vec2(0.0, px.y)).r);
float e = max(max(l + r - 2.0 * d, u + dn - 2.0 * d), 0.0);
float edge = step(uEdge, e);
c = mix(c, c * .5, edge * .85);
- AO: 8방향, 3px/6px 반경으로 깊이를 샘플링해 "앞에 선 것"이 있으면 최대 42%까지 어둡게 한다.
- 그림 합성과 마스크: 그림이 있는 곳에서는 엔진의 정적 도시를 그림이 덮는다. 움직이는 것(차·사람·행사·열기구)만 흰색 마스크로 한 번 더 그리는데, 본 패스의 깊이 텍스처를 그대로 공유하고 깊이 쓰기 없이 깊이 테스트만 한다. 그래서 차가 건물 뒤로 들어가면 마스크에서도 가려지고, 그 자리엔 그림이 남는다.
// 마스크 재질: 엔진 셰이더와 같은 변환, 카메라 쪽으로 아주 조금 당김 (요약)
const moveMat = new THREE.ShaderMaterial({ side: THREE.DoubleSide, depthWrite: false, depthFunc: THREE.LessEqualDepth,
  vertexShader: `... gl_Position.z -= .0004 * gl_Position.w; }`,
  fragmentShader: 'void main() { gl_FragColor = vec4(1.0); }' });
// POST_FS: 그림은 마스크가 없는 곳만 덮는다
vec4 p = texture2D(tPaint, vUv);
float mv = texture2D(tMove, vUv).r;
c = mix(c, p.rgb / max(p.a, 1e-3), p.a * (1.0 - mv));
c += texture2D(tGlow, vUv).rgb;
- 빛 효과는 따로: 처음엔 서치라이트·불꽃 같은 가산 효과가 마스크에 걸려서, 빔이 지나가는 자리만 그림 대신 엔진 화면이 비쳐 보였다. 빛 효과를 카메라 레이어 2로 빼서
rtGlow에 따로 그리고 마지막에 더했다. 이제 빔이 그림을 밝게 물들인다.
1. 데이터: 그림보다 먼저 고쳐야 했던 것
엔진 입력은 OSM 건물·도로·공원·물과 지형(DEM)이다. OSM에 빠진 건물은 Overture Maps로 채웠다. 처음 OSM에 없는 서울 건물 197,982채를 붙였고, 외곽은 0.6m 키웠다(Overture 외곽선이 실제 지붕보다 작게 잡혀서). 층수는 면적으로 추정했다.
추출 범위가 잘려 있었다. 서울 칸의 18%가 빈 땅으로 칠해진 걸 보고 찾았다. 건물·도로 추출이 위도 37.44–37.64, 경도 126.83–127.17로 잘려 있었고, 굽기(bake) 단계도 ±16km 한계에 건물 좌표를 Int16으로 저장하고 있었다. 범위를 37.40–37.73 / 126.74–127.20으로 넓히고, 16km를 넘으면 좌표를 Int32로 쓰게 바꿨다(엔진은 그대로 읽음). 칸 격자를 처음 만들 때 지형 높이를 빼고 계산해서 북한산(836m) 같은 높은 산이 화면 위로 밀려 칸 76개가 빠진 것도 이때 같이 잡았다.
높이. "별로 높지 않은 건물을 고층 아파트처럼 그린 곳이 많다"는 지적에서 시작했다. 건물 58.5만 채 중 실제 높이가 있는 건 9.2만(16%)뿐이었다. 나머지는 추정이었고, 예를 들어 용도 미상 3,000㎡ 이상은 8~18층, 주거 650㎡ 이상은 10~22층으로 올렸다. 넓고 낮은 시장·학교·빌라 묶음이 고층 덩어리가 됐고, 모델은 그걸 성실하게 아파트로 그렸다.
국토부 GIS건물통합정보(서울 등록 건물 68.7만, EPSG:5186)를 우리 건물에 붙였다.
- v1: "우리 면적의 30% 이상 겹치면 같은 건물". 저층 상가가 옆 초고층 단지에 붙어 15m가 250m가 되고, 283m 타워가 부속건물에 붙어 4m가 됐다.
- v2: 서로 50% 이상 겹치는 경우만 같은 건물로 보고, OSM에 실제 높이가 있으면 그대로 둔다. 20.4만 채에 공식 높이가 들어갔다. 4m 넘게 바뀐 건물이 8.5만(높아짐 3.8만, 낮아짐 4.7만), 25m 이상으로 추정됐지만 실제 15m 이하인 건물이 652채. IFC는 38m→284m, 63빌딩은 37m→250m로 실제와 맞았다.
- v3: 63빌딩 옆에 같은 높이 회색 판 건물이 생겼다. 저층부 외곽선(115×133m)에 부지 전체 높이 249.6m가 붙은 것이었다. 높이 40m 이상 건물 중 다른 건물을 품은 외곽선 29곳을 전수 검사했고, 저층부가 고층으로 오른 건 63 하나였다. 규칙을 추가했다. "안에 든 건물이 대장 높이의 30% 미만이면 대장 높이를 붙이지 않는다."
다시 그릴 칸은 벽 면적 변화율로 골랐다(height_diff.py). 1% 초과 3,269칸, 2% 2,629칸, 4% 1,747칸, 8% 788칸. 4% 기준 1,747칸만 다시 찍고 다시 칠했다(사전 추정 약 $8). 서남쪽의 15~25층 아파트 단지가 3~5층 빌라 골목으로 돌아왔다.
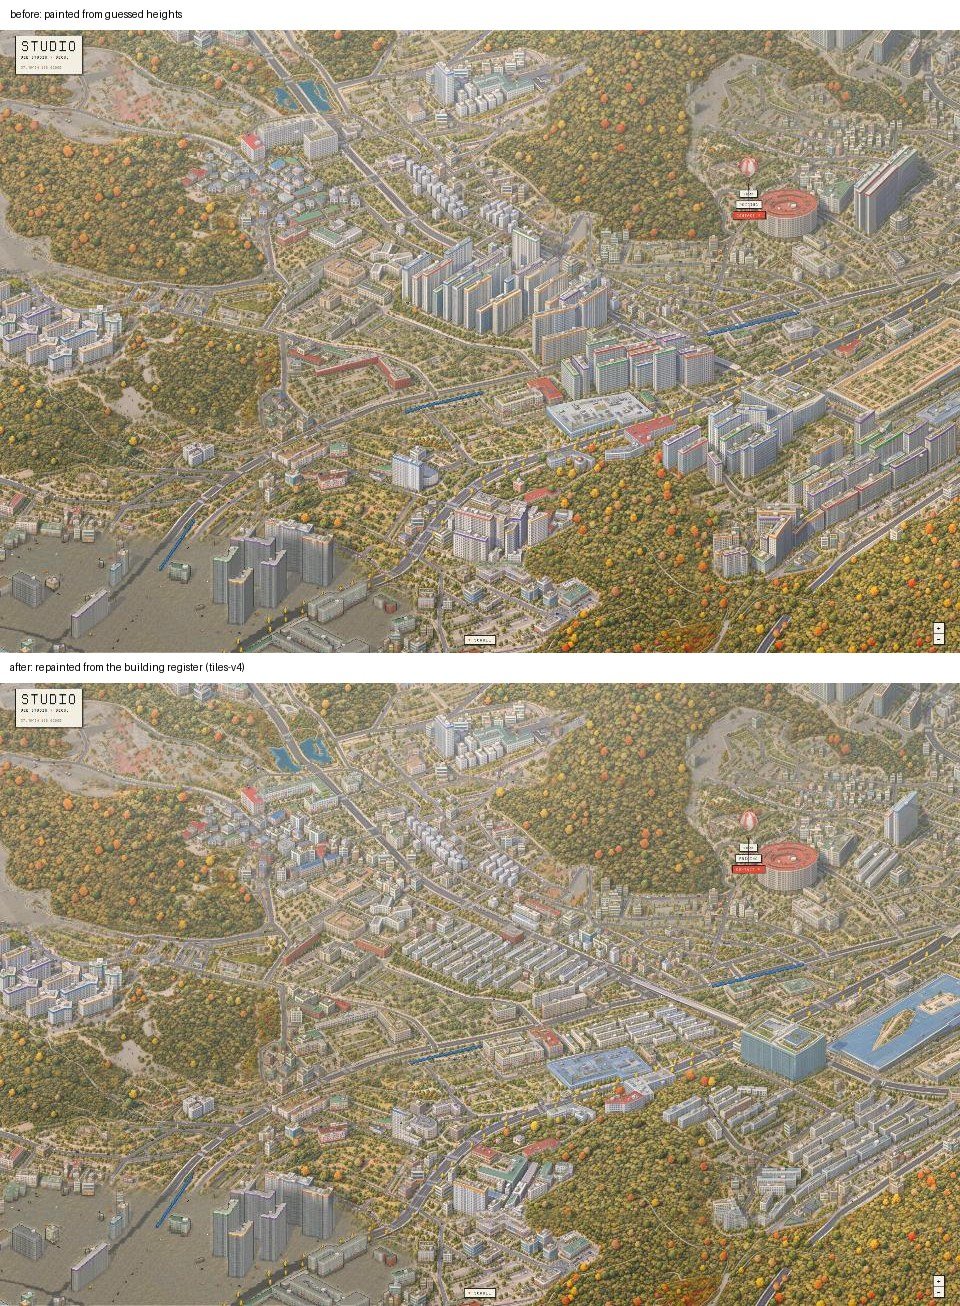
데이터와 그림이 서로를 검증한 셈이다. 모델의 실수처럼 보인 것 상당수가 입력의 실수였다.
2. 엔진: 그림 밑에 깔린 3D 서울
데이터는 Web Worker에서 청크 메시로 만든다. 건물은 셰이더 하나로 칠한다.
- 빛은 세 단계로 양자화했다(지붕 1.0, 해 쪽 벽 0.86, 반대쪽 0.66). 픽셀아트 도시처럼 보이게 하려는 것이다.
- 창문은 텍스처가 아니라 벽 좌표를 층고(2.9~3.4m)·창 폭(1.7~3.1m)으로 나눈 격자다. 멀리서는
fwidth로 앨리어싱을 줄이고, 밤에는 창문을 고르게 켜지 않고 몇 층·몇 칸씩 블록으로 켜고 끈다. ?mask=1이면 모든 셰이더가 정답 색만 낸다. 지은 것은 빨강, 물은 파랑, 숲·공원·도로는 각자 색. 그림 검사 도구(check.py)가 이 마스크와 그림을 대조한다.
if (uMask > .5) col = vec3(1.0, 0.0, 0.0); // ground-truth mask: every built thing is red
움직이는 것은 전부 인스턴싱이다(engine/life.mjs). 차와 버스는 실제 도로 위를 달린다. 도로는 길이에 비례해 고르는데, 서울 전체 도로가 약 4.2만 개라 누적 길이 배열을 이진 탐색한다. 경로 위 위치도 누적 거리 이진 탐색이다. 지하철은 처음에 노선색 통짜 상자를 경로 한 점의 각도로 돌려서 곡선에서 톱니가 생겼다. 차량마다 앞뒤 대차 두 점을 경로에 올려 위치와 방향을 정하게 바꿨다.
// 각 차량은 앞뒤 대차(±8m) 두 점 위에 선다. 차량 간격 20m
const dc = t.d - t.dir * c * 20; run.at(dc + 8, f); run.at(dc - 8, b);
const x = (f.x + b.x) / 2, z = (f.z + b.z) / 2, a = Math.atan2(f.x - b.x, f.z - b.z);
OSM에 터널 태그 없이 covered=yes나 layer<0으로만 표시된 선로가 464개 way 있었다(경의선숲길 밑 경의중앙선 등). 여기서 열차가 지상으로 달리고 있어서, 그 구간에서는 열차를 숨겨 터널로 들어가는 것처럼 만들었다. 보행자는 시간의 순수 함수로 움직인다. 화면 밖에서 갱신을 멈췄다가 다시 들어와도 그 시각의 위치가 바로 맞는다.
3. 그림 모델: GPT 한도에서 직접 학습으로
처음에는 엔진 렌더를 GPT 이미지로 칸마다 다시 그렸다(1024px, 0.3 m/px, 768px 간격, 이미 그린 옆 칸 띠를 붙여 이음새를 맞춤). 여의도 하나는 아름다웠다. 문제는 두 가지였다. GPT가 한강 물길을 옮기고 없는 연못을 만들고 공원에 빌딩을 세웠고, 하루 약 348장에서 이미지 한도에 걸렸다. 서울 전체는 약 6,000칸(밤 별도)이다. 생성 전에 칸 수 × 장당 비용 × 한도 × 일수를 먼저 계산할 것. 이게 첫 교훈이었다.
그림 조각을 패턴처럼 깔아 보기도 했다. 구역 지도(빌라/아파트/상업/공업/주차/학교/공터/문화재 8종)를 만들고, 종류별 그림 시트 4변형을 셰이더가 150m 축척으로 깔았다. 그래도 3D 상자 건물이 보이는 한 그림이 되지 않았다. 결론은 "그림의 패턴화 = 우리 그림체를 학습한 모델"이었다.
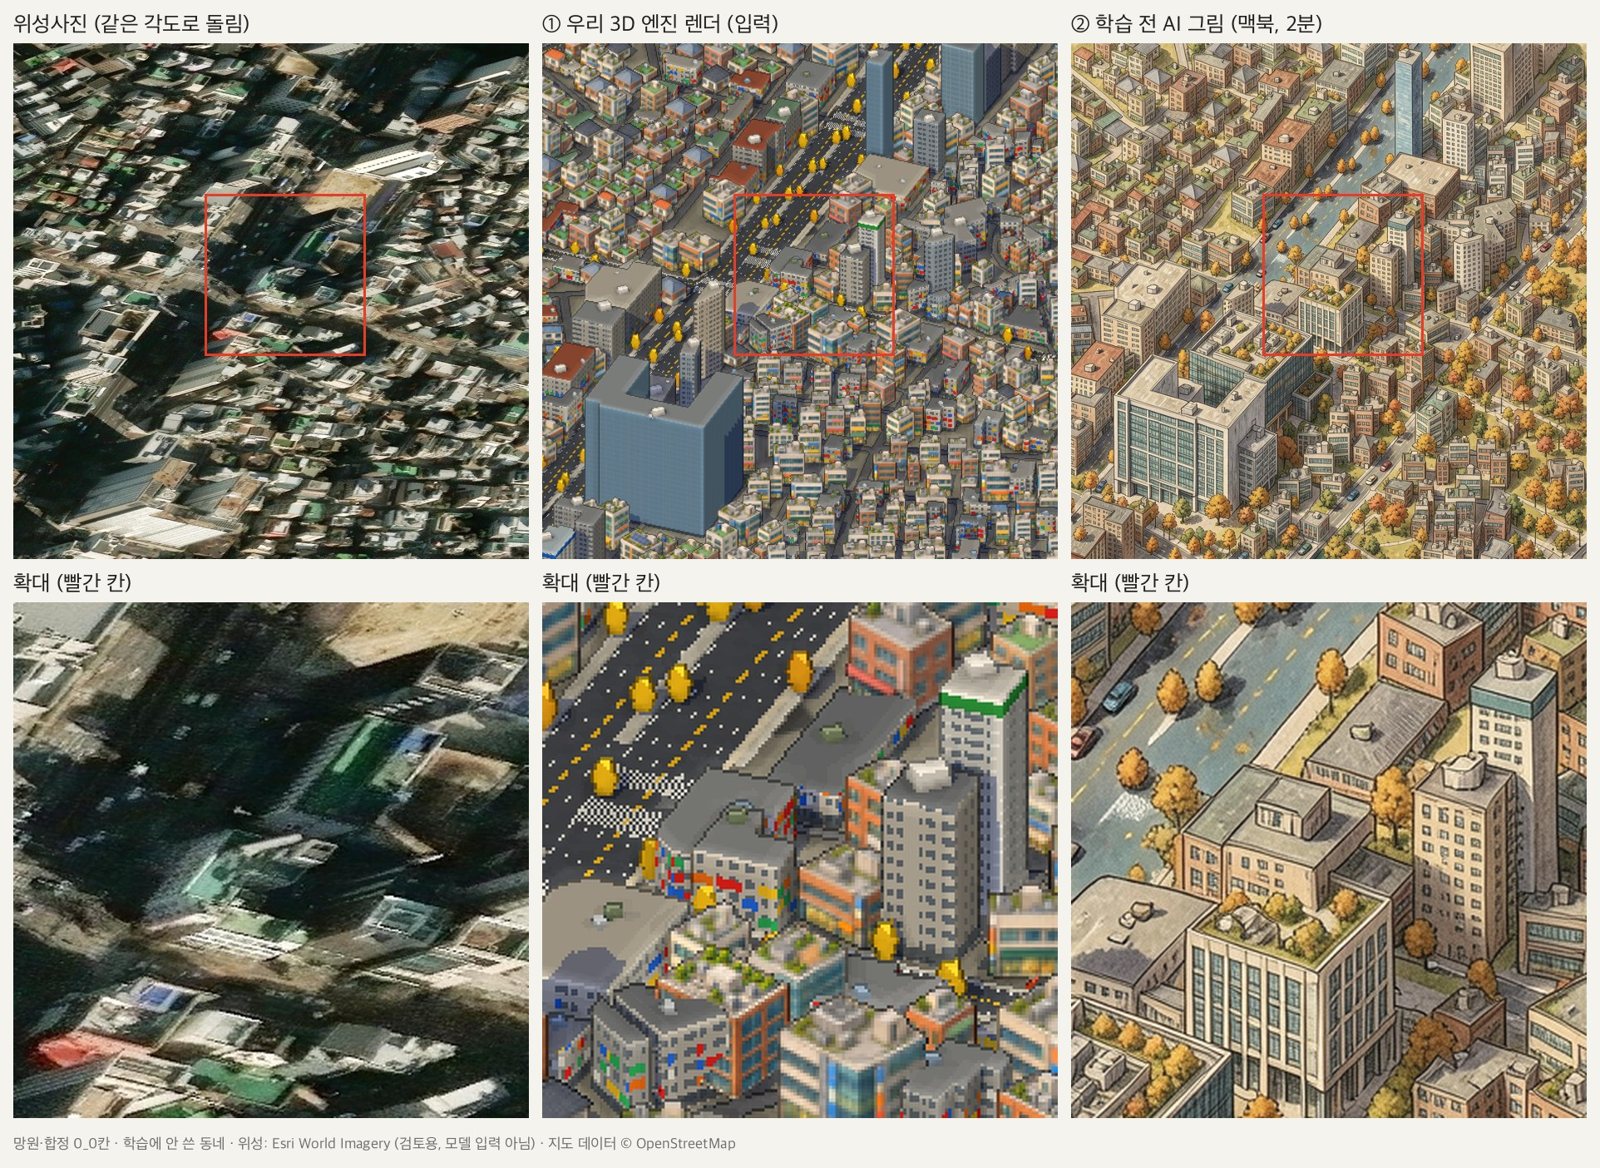
공개 모델 FLUX.2 klein 4B(Apache 2.0)에 편집 LoRA를 학습시켰다. 입력(reference)은 엔진 렌더, 정답(target)은 같은 칸을 그린 그림이다.
| 회차 | 장비·도구 | 자료 | 설정 | 속도 | 결과 |
|---|---|---|---|---|---|
| r1 | 맥북 M3 Pro, mflux | 92쌍 | 768px, rank 16, 8비트, 12에포크(1,104단계) | 77초/단계 | 약 4밤 예상. 입력·정답 불일치 발견 후 중단 |
| r2 | 맥북 | 33쌍 | 512px, 396단계 | 57초/단계 | 증류 모델에서 물을 지어냄. 학습 부족 판단 |
| r3 | Kaggle T4×2(무료), ai-toolkit | 33쌍 | 참조 512px, 1,000단계, rank 32/64 | 31~35초/단계 | 디테일이 거칢. 운하·숲 섬 남음 |
| r4 | Modal A100-80GB, ai-toolkit | 33쌍 | 참조·정답 1024px, 양자화 없음, rank 64, 1,500단계 | 2.41초/단계 | 채택 |
막혔던 지점을 하나씩 적는다.
스크립트 버그로 첫 밤을 날렸다. 이어받을 체크포인트를 찾는 줄이 아무것도 못 찾으면 현재 폴더 목록을 내놓았고, 그 폴더를 체크포인트로 열려다 1초 만에 죽었다. 약 3시간 뒤에야 알았다.
학습 데이터 자체가 틀렸다. 위성사진(검토용으로만 씀)을 우리 카메라 각도로 펴서 대조해 보니, OSM에 건물이 빠진 빈 땅을 정답 그림이 숲으로 칠해 두었다. 모델이 "빈 땅 = 숲"을 배우고 있었다. 게다가 학습 입력을 다시 찍는 사이에 엔진이 빈 블록을 가짜 건물로 채우게 바뀌어 있어서, 입력과 정답이 안 맞는 쌍으로 학습하고 있었다. pairscore.py로 "원래 입력에 빠진 실제 건물 <6%, 정답이 지어낸 것 <20%"를 통과한 쌍만 남겨 33쌍으로 줄였다.
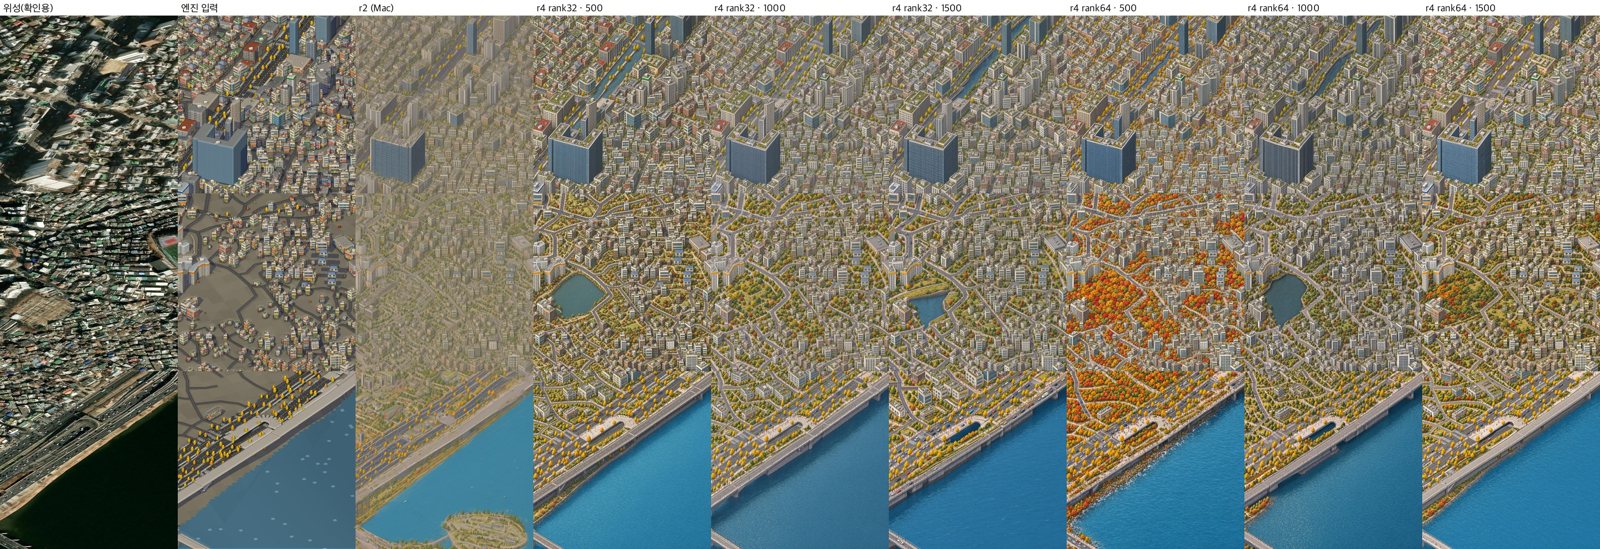
물을 지어내는 버릇. base 모델로 학습한 LoRA를 빠른 증류(distilled) 모델에 끼우면 큰 도로를 운하로 바꿨다. 랜덤 시드 4개 모두 같았다. 우연이 아니라 학습된 버릇이었다. 같은 LoRA를 base 모델로 돌리면 운하가 사라졌다. 최종 변환도 학습과 같은 FLUX.2-klein-base-4B에서 돌린다.
T4에서 매번 정확히 3단계에서 OOM. 처음엔 fp16이 빠르길래 썼다(예열 후 실측 fp16 24 TFLOPS, bf16 2.5. T4는 bf16을 흉내만 낸다). 그런데 fp16에서 loss가 NaN이 됐다. FLUX 계열에서 알려진 문제다. fp32는 정상이지만 58초/단계로 맥북과 같았다. bf16은 26초/단계인데 3단계에서 메모리가 터졌다. 메모리 조각 모음, rank 16, 모델 절반 CPU 오프로드를 다 해 봐도 매번 3단계였다. 학습 도구 코드를 직접 읽어 보니 FLUX.2 편집 학습에서 참조 이미지를 원본 크기 그대로 쓰고 있었다. 참조 1024px, 정답 512px이니 참조 쪽 토큰이 4배였다. 참조를 512로 줄이자 27초/단계로 끝까지 돌았다. 같은 단계에서 반복해서 죽으면 설정이 아니라 입력 크기다.
A100에서 끝냈다. 24GB 이상이면 1024 참조를 그대로 넣을 수 있다. 채택한 설정의 핵심은 이렇다.
# gen/finetune-20261019/modal/train_modal.py가 만드는 ai-toolkit 설정 (발췌)
network: {type: lora, linear: 64, linear_alpha: 32}
train: {batch_size: 1, steps: 1500, lr: 0.0001, optimizer: adamw8bit,
        gradient_checkpointing: true, dtype: bf16, noise_scheduler: flowmatch}
model: {arch: flux2_klein_4b, name_or_path: black-forest-labs/FLUX.2-klein-base-4B,
        quantize: false, quantize_te: true}
r4는 rank 32와 64를 동시에 1,500단계(약 65분) 돌렸다. rank 32는 500·1,000·1,500단계 모두 망원에 운하, 용산 공사장에 연못을 그려 탈락했다. rank 64도 1,000단계에서는 연못·운하가 나왔다. 물 버릇이 사라진 게 아니라 흔들리다 1,500단계에서 잡힌 것이다. 학습에 안 쓴 16칸(여의도 8, 용산 8)에서 지어낸 물이 0이었고, 시험 3칸 × 시드 2개에서도 0/6이었다.
검증하다 다시 학습시킨 실수. 학습된 LoRA를 불러 샘플만 뽑으려 했는데, ai-toolkit이 불러온 LoRA에 저장된 단계 수를 무시하고 0단계부터 다시 학습을 시작했다. 30분 뒤에 알았다. 로컬 프로세스를 꺼도 원격 앱은 남아 있어서 따로 멈춰야 했다. 고친 뒤로는 start_step을 학습 단계 수로 고정한다. 서울 전체 변환도 같은 방식이다. "학습이 이미 끝난 학습 작업"을 띄워서 샘플 생성만 시킨다.
# convert: 학습 없이 샘플만 (start_step = steps)
return run(name, steps, rank, 1024, 100000, W='/vol/conv', lora=f', pretrained_lora_path: {lora_path}',
           items=items, extra_train=f'\n        skip_first_sample: true\n        start_step: {steps}')
4. 서울 전체 변환: 51분
추론 비용은 스텝과 guidance로 줄였다. A100에서 6칸 × 4방식을 실측했다.
| 방식 | 칸당 시간 | 관찰 |
|---|---|---|
| 8스텝, guidance 3 | 8.6초 | 기준 |
| 8스텝, guidance 1 | 4.1초 | 땅·물결 질감이 아주 조금 납작. 구조·건물·색은 거의 같음 |
| 6스텝, guidance 3 | 5.8초 | |
| 6스텝, guidance 1 | 3.2초 | |
| 4스텝, guidance 1 | 2.3초 | 땅이 흐려짐 |
guidance 1은 대조 안내를 끈 설정이다. 같은 8스텝에서 시간이 절반 아래로 줄었고, 물 지어냄은 어느 방식에도 없었다. 8스텝·g1이면 6,000칸이 약 6.8시간(약 $17)이라 남은 무료 크레딧 안에 들어왔다. 이걸로 정했다.
밤 작업은 이렇게 돌았다. 01:01 엔진 촬영 시작(헤드리스 Chromium, 1024×1024 뷰포트, UI·나무·움직이는 층을 숨기고 카메라 높이를 고정해서 칸당 약 0.7초). 02:37 Modal A100 10대 동시 변환 시작. 컨테이너당 628~629칸, 칸당 4.9초, 51분 만에 6,394칸(603km²) 전부. 오류·OOM·NaN 0, 빠진 칸 0.
Modal 누적 사용은 $35.88(무료 크레딧 $30 포함)이었고, 예상($31)보다 높았던 건 컨테이너마다 모델을 올리는 시간 때문이다.
5. 이어 붙이기와 자동 보정
칸마다 따로 그린 그림을 한 장으로 만드는 체인이다(run_post.sh).
water_qa → water_fix → forest_grade → harmonize → shade → build_pyramid(R=96) → manifest
물 검사. 엔진 렌더와 그림의 픽셀 위치가 같으니 "엔진에서 물인 자리가 그림에서도 파란가"를 셀 수 있다. 엔진 물 마스크 위치에서 그림 픽셀이 B > R + 30 && B > G인 비율이 0.85 미만이면 실패다. 물 있는 칸 949개 중 물이 80% 이상인 칸 194개에서 176개가 실패했다. 강가가 하나도 안 보이는 한강 한가운데 칸을 모델이 단풍 숲으로 칠했다. 학습 쌍에 물만 있는 칸이 없었던 탓으로 본다.
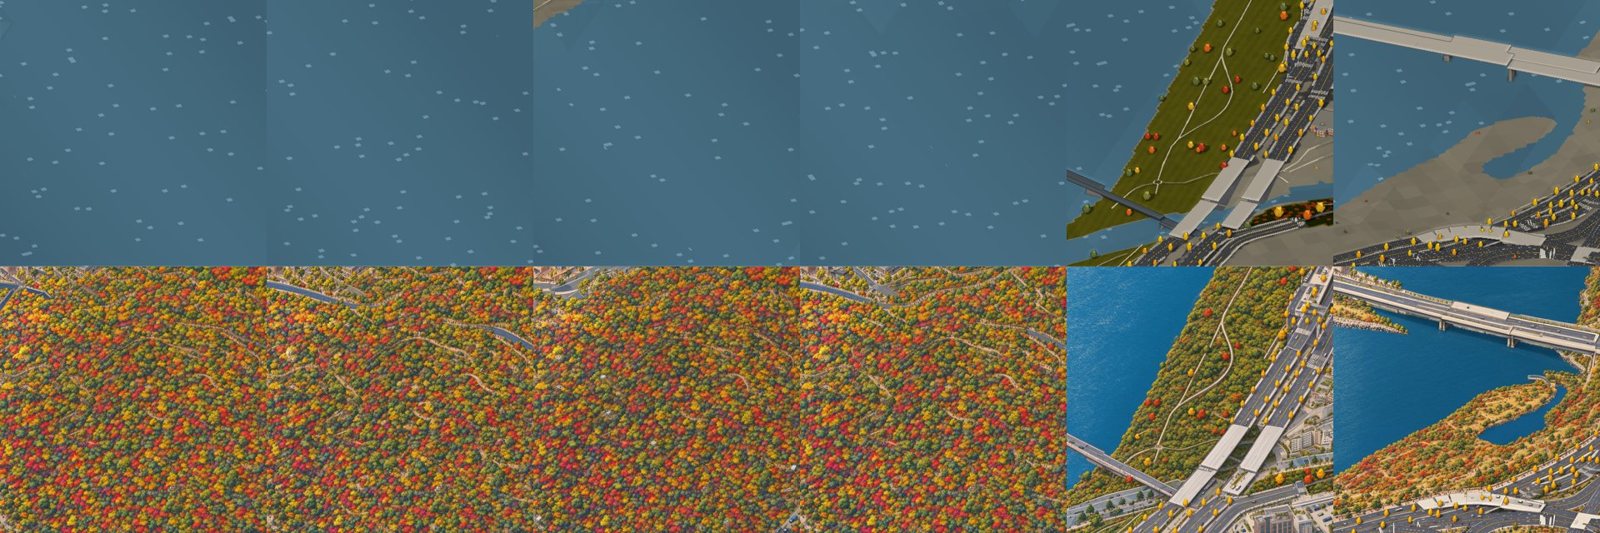
물 보정 v2. v1은 엔진 물의 밝기 띠를 색 기준으로 썼는데, 그 밝기가 칸(카메라 위치)마다 달라서 한강에 네모가 보였다. 빈 칸의 잔물결을 한 조각에서 거울 복사해 채운 것도 확대하면 반복이 보였다. v2는 물 자리를 세 층으로 다시 만든다. 도시 전체에 같은 파랑(42, 92, 120), 칸 좌표가 아니라 캔버스 좌표로 깐 느린 밝기 장(칸 사이로 이어짐), 그리고 잔물결(그 칸이 물을 지켰으면 그 칸의 고주파 성분 60%, 아니면 칸 ID로 시드를 정한 절차적 노이즈).
# water_fix.py (발췌)
det = OWN * (o - lp(o, 6)) if blue >= 0.85 else ripples(t)
new = np.clip(PM + field(t)[..., None] + det, 0, 255); out = o * (1 - a) + new * a
격자 지우기(harmonize). 칸마다 색이 조금씩 달라 격자가 보였다. 칸마다, 채널마다 3×3 제어점의 로그 게인을 미지수로 두고, 이웃 칸의 겹침 띠(3구간씩)가 같아지도록 희소 최소제곱(lsqr)으로 풀었다. 변화 없음(게인 0)으로 당기는 항과 제어점 사이를 매끄럽게 하는 항을 같이 넣었다. 1/8 축소로 풀고, 게인 장은 쌍선형으로 펴서 원본에 곱한다. 겹침 차이가 약 1/4로 줄었다.
좁은 넘김(build_pyramid). 처음엔 256px 겹침 전체를 선형 페이드했더니, 두 칸이 같은 건물을 조금 다르게 그린 곳에서 반투명 "유령 겹침"이 생겼다. 지금은 칸마다 겹침 한가운데 768px 셀을 자기 몫으로 갖고, 셀 경계 양쪽 96px에서만 섞는다.
def ramp():  # 셀 로컬 좌표 -R/2..C+R/2에서 자기 칸의 가중치 (R=96, C=768)
    u = np.arange(-R // 2, C + R // 2, dtype=np.float32)
    return np.clip(np.minimum(u + R / 2, C + R / 2 - u) / R, 0, 1)
그 위에 랜드마크 패치(RGBA)를 세계 좌표로 합성하고, 알파는 실제 서울 경계(OSM 행정 경계를 같은 카메라와 지형 높이로 투영, 20m 간격으로 촘촘하게)에서 160px 페더로 정한다. 타일 계단 모양 대신 서울 모양으로 끝난다. 아래 레벨은 premultiplied 알파로 2×2 평균을 내서 만든다.
지형 명암(shade). 엔진은 지형을 올리지만 그림은 산을 평평한 무늬로 그렸다. 칸 픽셀마다 고정 카메라를 지형에 역투영하고(고정점 반복 3회), 지형 노멀에 화면 왼쪽 위에서 오는 빛을 곱했다. 처음엔 80m DEM 격자의 쌍선형 기울기가 칸마다 튀어서 네모난 명암이 생겼다. 살짝 흐린 지형을 3차 보간으로 읽어 노멀을 계산하니 북한산·남산이 입체로 살아났다.
모델의 버릇들. 숲은 엔진 숲이 거의 검정에 빨간 점이라 산 전체가 주황·빨강으로 칠해졌다. 엔진 숲 자리의 빨강·주황을 올리브 쪽으로 당겼다(머스터드 → 라임 → 올리브+주황 점, 세 번째 채택, 4,658칸). 물만 있는 칸에서 늘 칸 왼쪽 위 같은 자리에 작은 나무 섬을 그리는 버릇도 있었다. 그 자리를 전 칸 검사해서 7곳을 지웠다. 검사 기준은 "물에 둘러싸인 외딴 덩어리 + 주변 물과 색이 확실히 다름"인데, 덩어리 판정은 엄격하게, 둘레는 느슨하게 해야 파란 나무 섬까지 잡혔다.
6. 다시 그리기: 표시하고, 그리고, 정합하고, 패치로
모델은 랜드마크에 약하다. 롯데월드·DDP 같은 건물이 일반 건물로 나왔다. 그 자리만 GPT로 다시 그리는 도구를 만들었다.
lm_prep.py: 서울 그림에서 주변을 자르고, OSM 외곽선과 높이를 같은 카메라와 지형으로 투영해 빨갛게 표시한다. 앞에 선 건물은 엔진 건물의 실제 높이로 가림 윤곽을 계산해 표시에서 뺀다. 안 그러면 GPT가 앞 건물까지 지운다.- GPT가 표시된 부분만 다시 그린다.
lm_apply.py: GPT 결과는 조금 밀리거나 커질 수 있다. 표시 바깥(40px 띄운 영역)만 보고 ECC 아핀 정합을 한 뒤, 표시 부분만 페더 알파 패치로 저장한다.
# lm_apply.py (요약): 표시 밖 영역만으로 ECC 아핀 정합
outside = (~binary_dilation(mk, iterations=40)).astype(np.uint8)
_, warp = cv2.findTransformECC(blur(crop), blur(gpt), np.eye(2, 3, dtype=np.float32), cv2.MOTION_AFFINE,
                               (cv2.TERM_CRITERIA_EPS | cv2.TERM_CRITERIA_COUNT, 200, 1e-6), outside, 5)
ga = cv2.warpAffine(g, warp, (Wd, H), flags=cv2.INTER_LINEAR + cv2.WARP_INVERSE_MAP)
정합 오차는 첫 11곳이 0.4px 미만, 여의도 8장 0.5px 이내, 궁궐 9장 0.6px 이내였다. GPT가 표시 높이보다 높게 그린 안테나 끝이 페더에 걸려 흐려지는 문제가 있어서, 표시에 붙어 있는 확실한 변화(90px 안)는 함께 살리는 옵션(GROW)을 넣었다. 패치는 세계 좌표로 저장해서 피라미드를 다시 만들어도 자리가 유지된다.
여의도: 예쁜 조각보다 이어진 전체. 여의도는 처음부터 GPT로 칸마다 공들여 그린 구역이었다. 그런데 칸 경계마다 강변선이 계단처럼 어긋나고 공원 길이 끊겼다. 두 그림이 같은 카메라라서 평행 이동 하나(41464, 40850)로 정확히 겹친다는 걸 이용해 강변 자르기, 선착장 정리, 저해상도 밑그림 보정까지 며칠을 버텼다. 그 과정에서 밑그림 폭(12,544px)과 칸 격자 폭(13,312px)을 섞어 쓴 버그도 찾았다. 그래도 결론은 "아예 다시 그려야 한다"였다. 공들인 여의도 그림을 끄고, 매끈하게 이어진 학습 모델 그림 위에 63빌딩·IFC·파크원·여의도공원(넓어서 4조각)만 다시 그렸다.
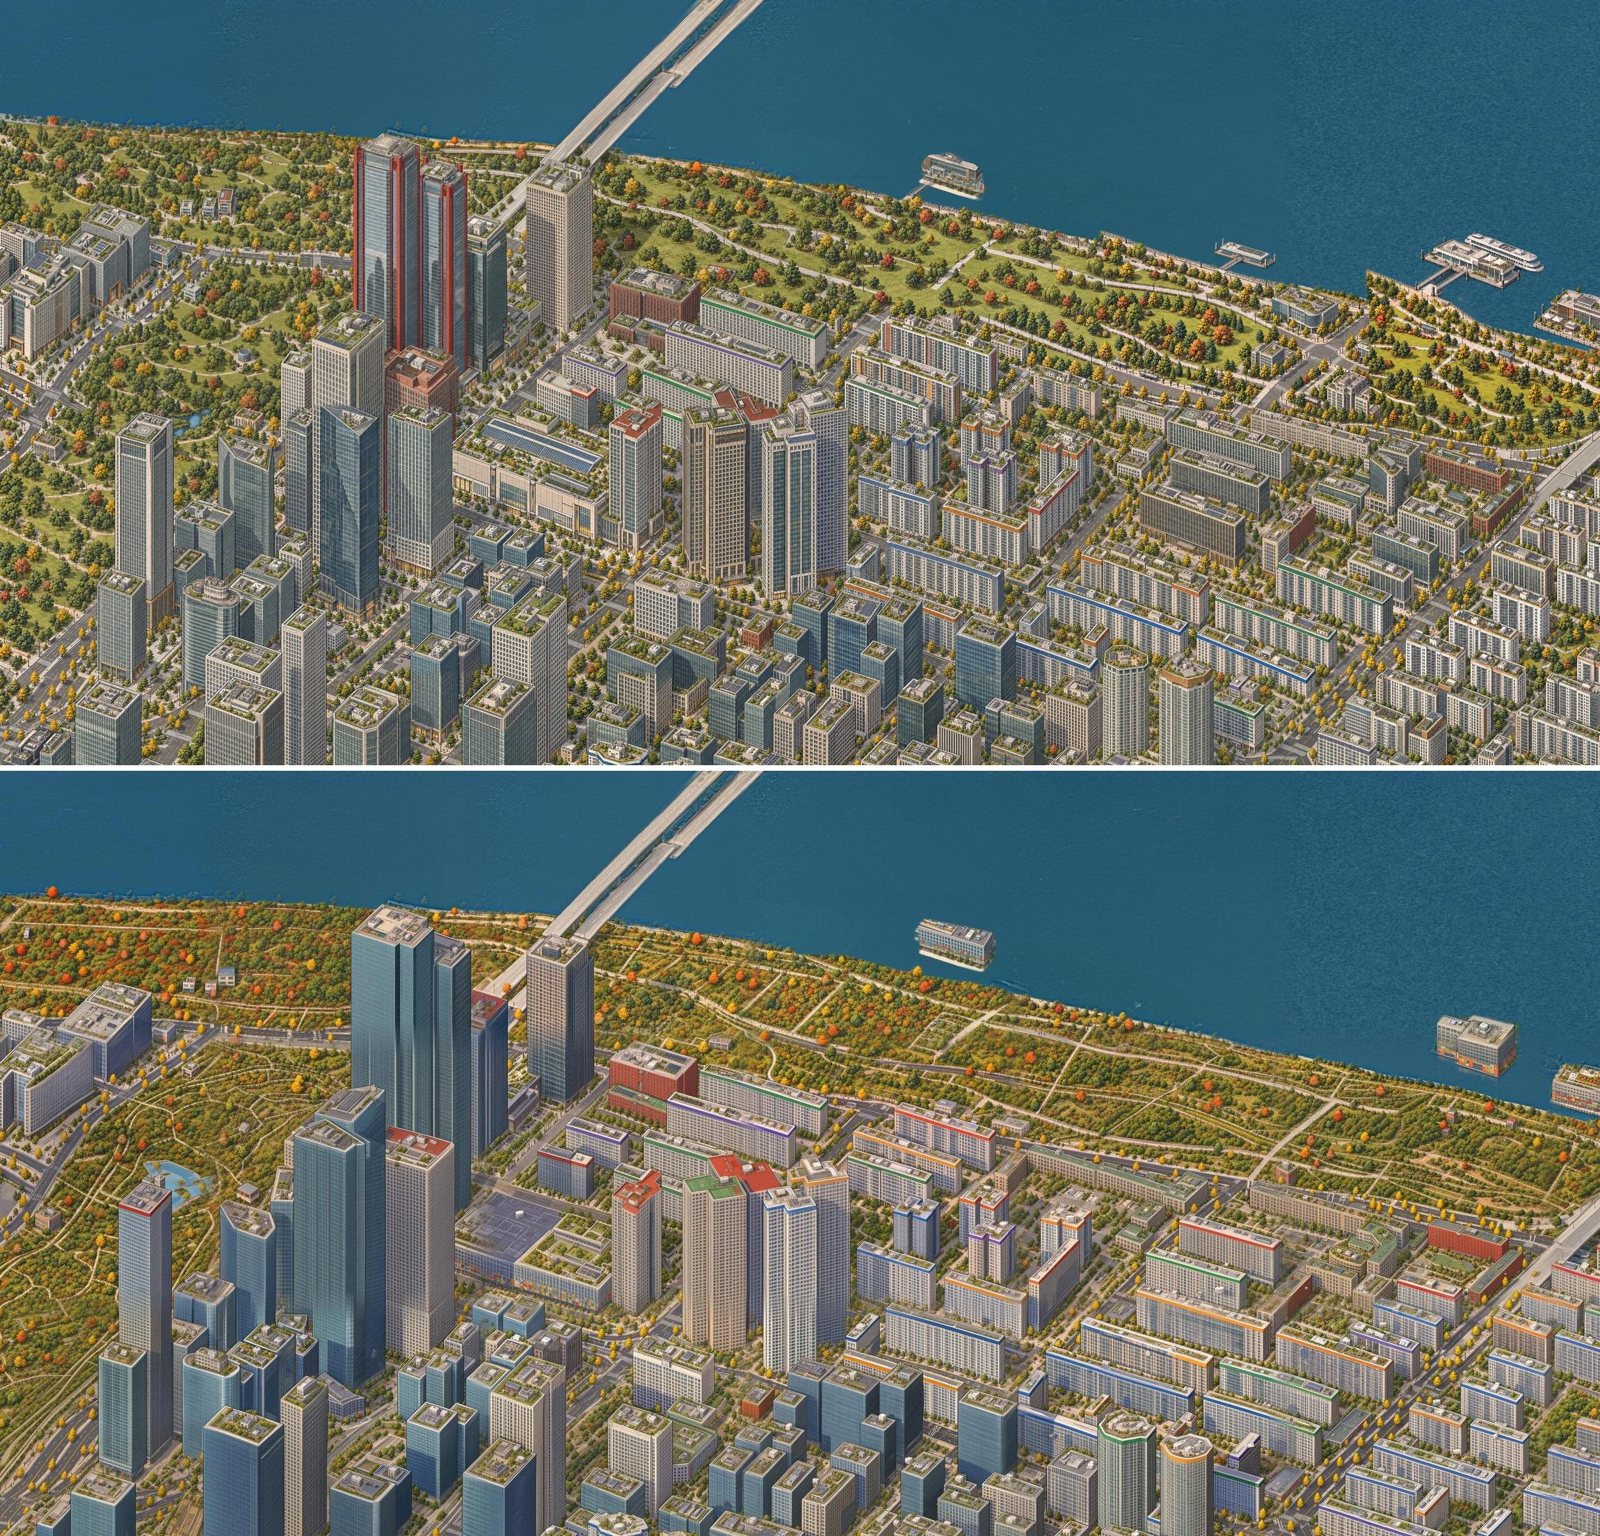
한강 다리. 칸마다 그린 그림은 긴 다리를 칸마다 조금씩 다르게 그린다. 겹침 영역에서 두 칸을 직접 비교하니 다리 위치가 최대 40px 넘게 다르고, 폭과 차선 디자인도 달랐다. 수학적으로 맞추는 건 절반만 통했다.
- 시도 1: 두 칸 사이 이동량을 재서 반씩 밀기. 상관이 약하고 이동만으로는 안 맞았다.
- 시도 2: 칸마다 "물이 아닌 띠"로 상판 중심과 폭을 재서 엔진 다리선 폭에 맞추고, 다리 근처에서는 섞는 가중치를
w ** (1 + 3 * bridge_mask)로 날카롭게. 잔상은 사라졌지만 디자인 단차가 남았다. - 결론: 다리 하나를 강 끝에서 끝까지 한 장에 넣어 다시 그린다. 엔진 다리선 중 한강 중심선을 건너는 24곳을 묶고, 긴 다리 15곳은 겹치는 두 장으로 나눠 두 번째 장이 첫 장의 끝을 보고 이어 그리게 했다. 경계 밖이라 원래 그림이 없는 2곳을 빼고 GPT 37장.
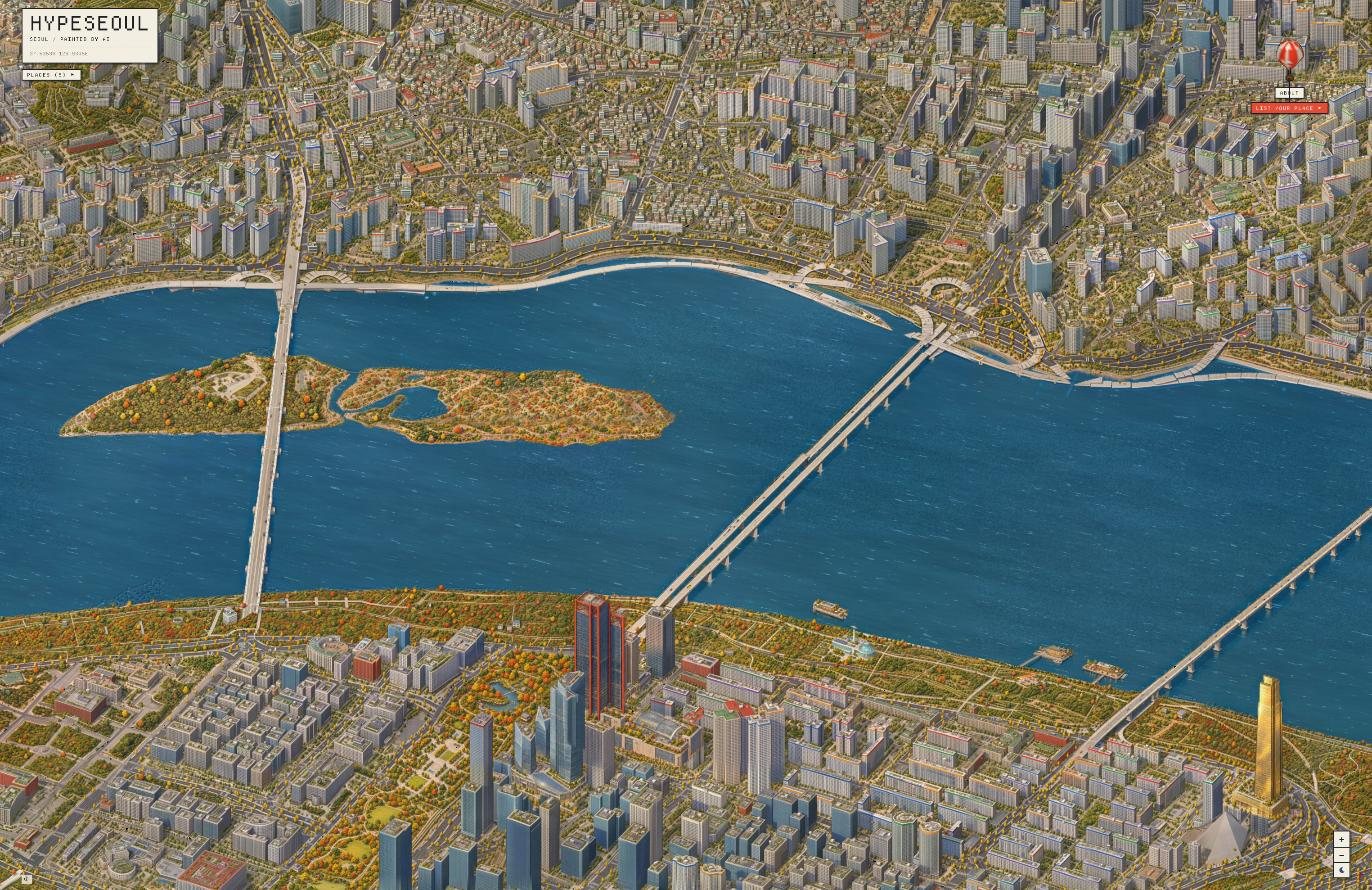
10-26에는 같은 도구에 월드 폴리곤을 직접 넣는 'poly' 소스를 추가해 한강공원 주차장 17곳과 강남·성수 일대 랜드마크 9곳을 다시 그렸다(26장 전부 1차 통과). 실제로 바이트가 바뀐 타일은 190개였고 그것만 다시 올렸다.
출시 직전 점검에서 63빌딩이 틀렸다. 금색 탑 아래에 거대한 금색 기단이 생겨서 앞에 있던 중층 건물들을 덮어버렸다. 원인은 데이터였다. 건축물대장 높이를 채우는 과정에서 단지 전체 외곽선(115×133m)에 탑 높이 249m가 붙었고, 그 외곽선을 그대로 빨갛게 세워서 표시했다. GPT는 표시를 꽉 채우라는 지시대로 거기에 건물을 그렸다. 같은 단지 안에 120m짜리 상자 두 개도 데이터 오류였다.
그래서 표시를 두 색으로 나눴다. - 빨강: 진짜 남길 것. 탑 윤곽(250m)과 낮은 기단(14m)이다. - 파랑: 데이터 오류로 학습 모델이 그려 버린 가짜 건물. "여기엔 건물이 없다, 뒤에 있는 강변 공원과 길을 이어 그려라"라고 지시했다.
처음엔 GPT가 파랑을 무시하고 회색 판상 건물을 그대로 남겼다. 그래서 GPT에 넘기는 참고 그림에서 파랑 영역을 미리 OpenCV 인페인팅으로 뭉개서 넘겼다. 원본에 보이는 건물이 없으니 그대로 따라 그릴 것도 없다. 앞에 선 건물은 엔진 건물 높이로 가림 윤곽을 계산해서 표시에서 뺐다(occlude='front').
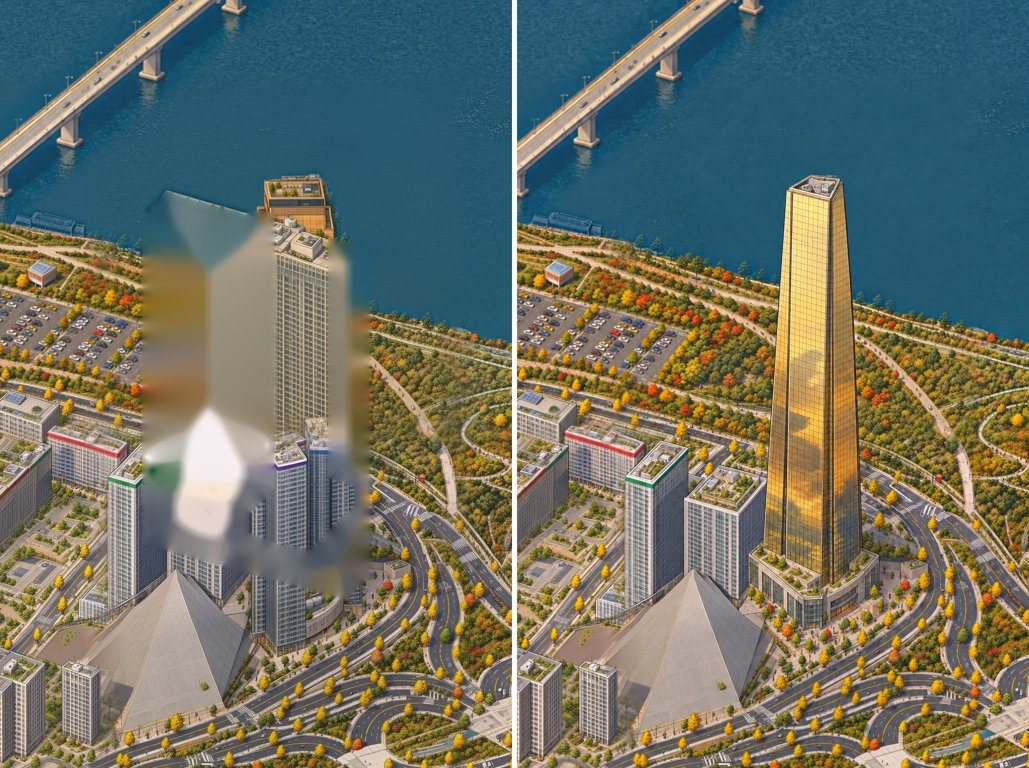
IFC는 반대 문제였다. 원래 그림의 큰 탑이 표시보다 넓었다. 그래서 새로 그린 뾰족한 탑 옆으로 옛 탑의 평평한 옥상이 반투명하게 비쳤다. 같은 방법을 표시 전체로 넓혀서 고쳤다(prefill=True). GPT에 넘기는 참고 그림에서 표시 영역 전체를 미리 지우면, 옛 건물을 따라 그릴 근거가 없어진다.
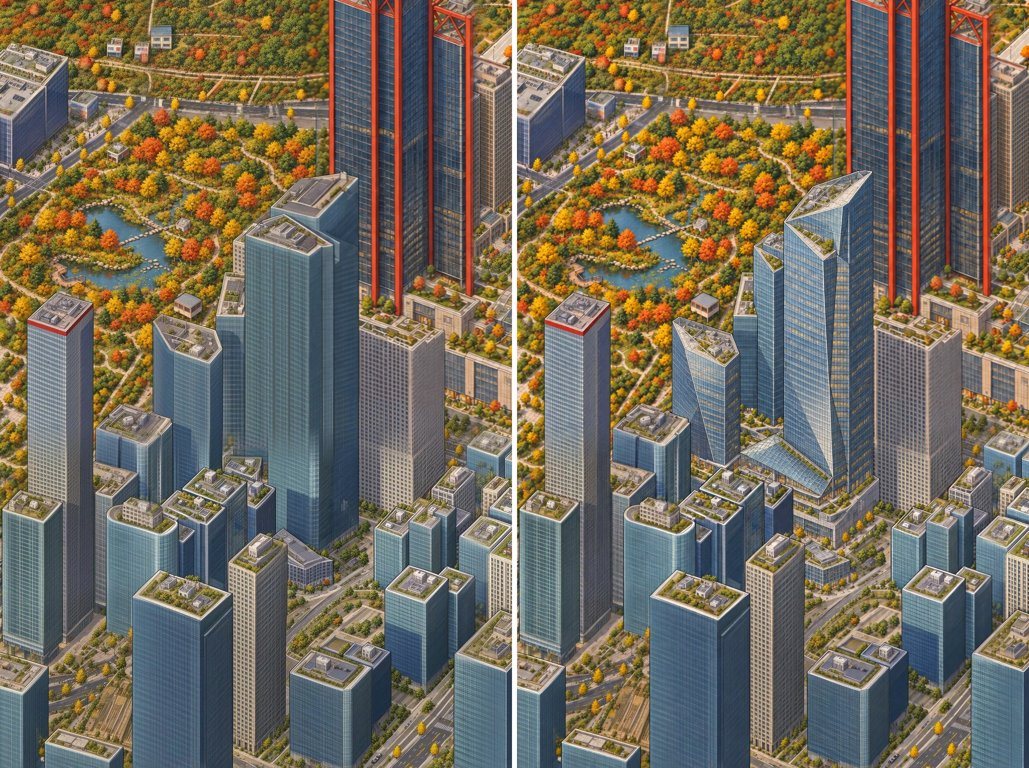
교훈은 랜드마크를 덮을 때 표시 범위가 곧 덮어쓸 범위라는 것이다.
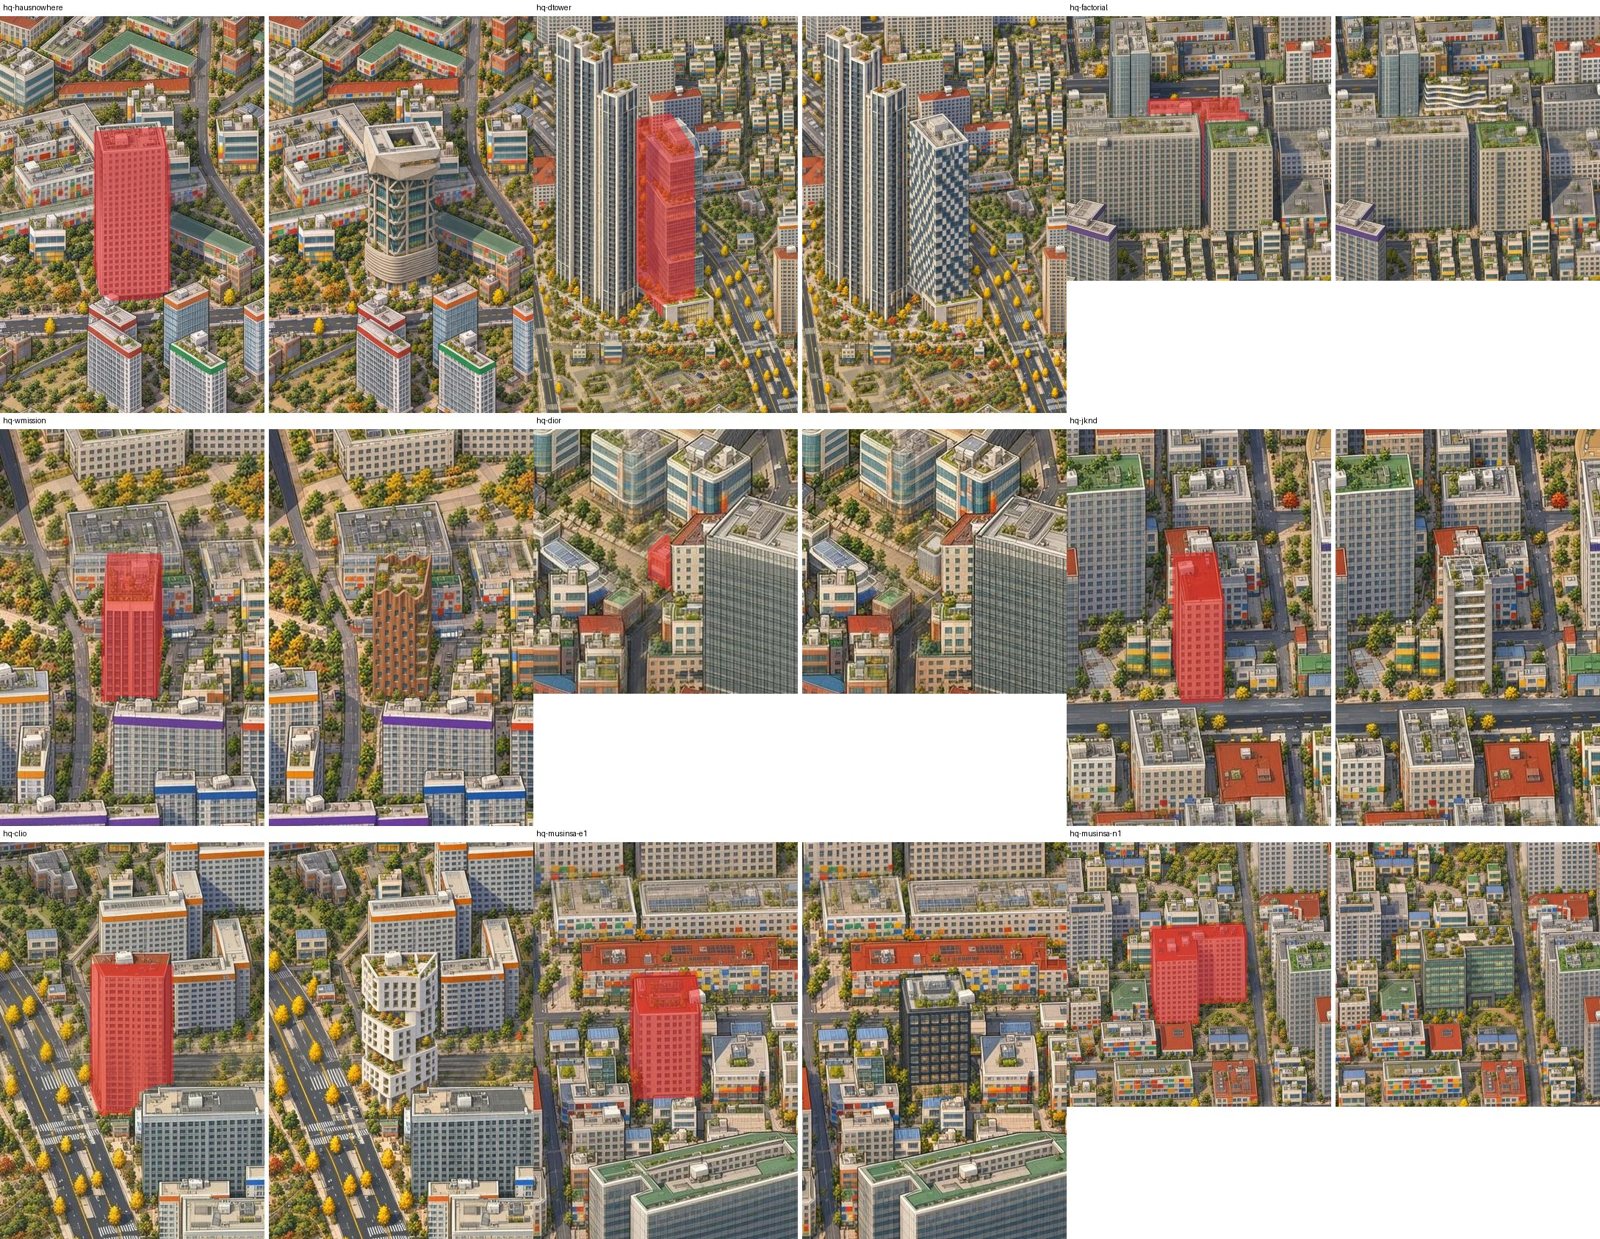
이 규칙으로 성수의 기업 사옥 9곳을 새로 그렸다. 젠틀몬스터 본사 하우스 노웨어, 아크로 서울포레스트 D타워, 팩토리얼 성수, W미션, 디스이즈네버댓 사옥, 클리오, 무신사 E1·N1 같은 곳이다. 위치는 카카오맵 좌표에 가장 가까운 OSM 외곽선으로 잡고, 높이는 조사 자료를 썼다. 표시 전체를 미리 지우고 앞 건물은 표시에서 뺐다. 8곳은 한 번에 통과했다. 디올 성수는 2층짜리라 지도 크기에서는 거의 보이지 않아서 뺐다.
이어서 건축상을 받았거나 위에서 봐도 알아볼 만한 건물 14곳을 17장으로 나눠 그렸다. 국립중앙박물관, 예술의전당, 올림픽공원 평화의문과 KSPO 돔, 전쟁기념관, 아모레퍼시픽 본사, 서울식물원, 종로타워, 서울역 구역사, 이화여대 ECC, 문화비축기지, LG아트센터, 세종문화회관, 삼성타운, 서울스퀘어다. 준비 단계에서 세 가지가 걸렸다. - 삼성타운을 반경으로 찾았더니 메리츠타워까지 주변 빌딩 13동이 딸려 왔다. 높이 150m 넘는 3동만 남겼다. - 지하에 묻힌 ECC는 주변 건물이 전부 '앞에 선 건물'로 판정돼서 표시가 0%가 됐다. ECC만 가림 처리를 껐다. - 박물관(약 400m)과 문화비축기지는 한 장에 담으면 GPT 출력이 원래 해상도보다 작아져서 흐려진다. 그래서 겹치는 두 조각으로 나눴다.
17장 중 15장이 한 번에 통과했다. 올림픽공원 두 장은 평화의문과 돔의 설명을 한 문장에 같이 넣은 탓에, 돔 자리에 문을 그리고 문 자리에 돔을 덧그렸다. 장마다 그것만 그리라는 설명으로 바꿔서 다시 그렸다.
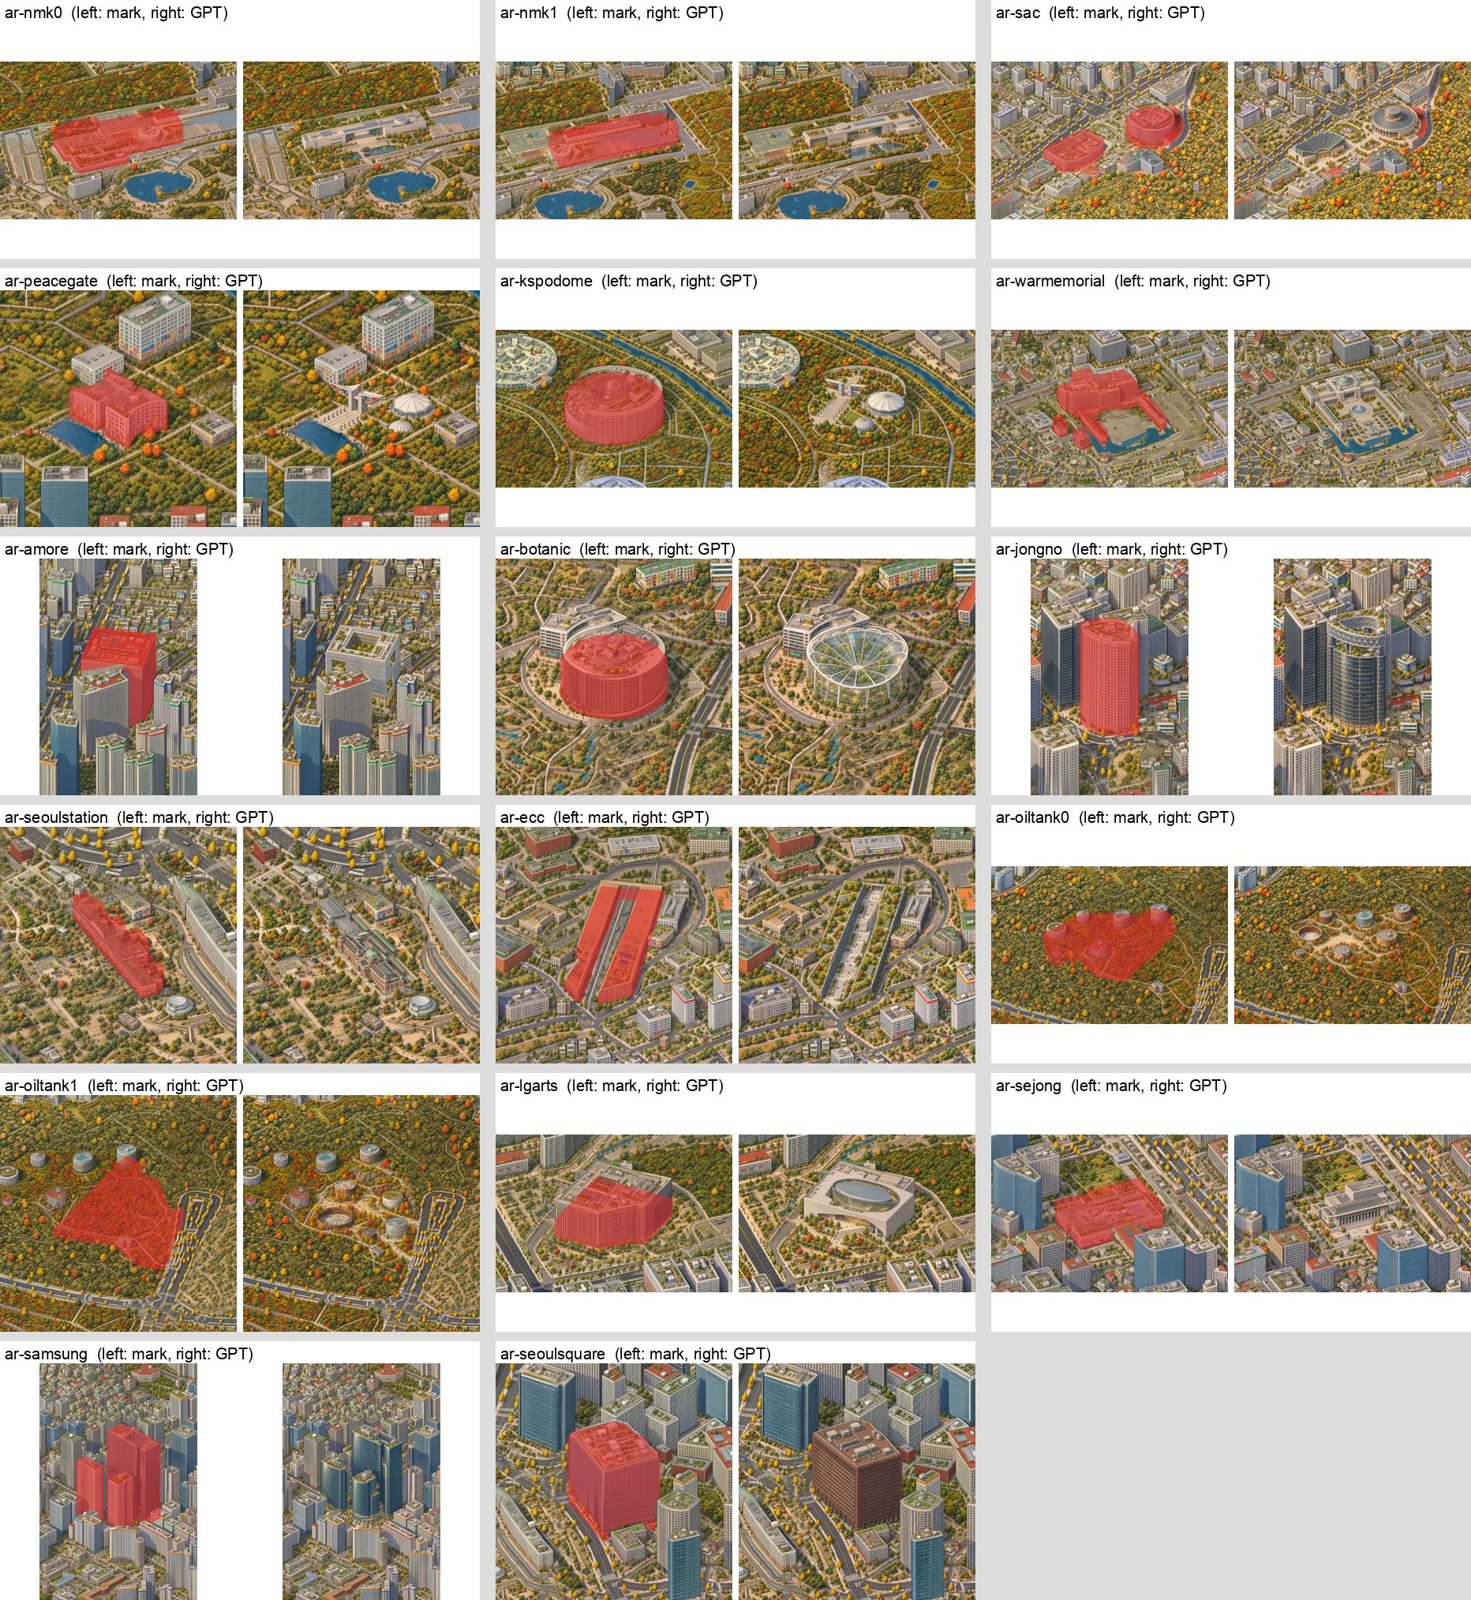 주변을 먼저 보고, 부분마다 실제 높이를 쓰고, 지도에 올린 뒤 주변까지 확인한다.
7. 야경은 그림이 아니라 데이터로
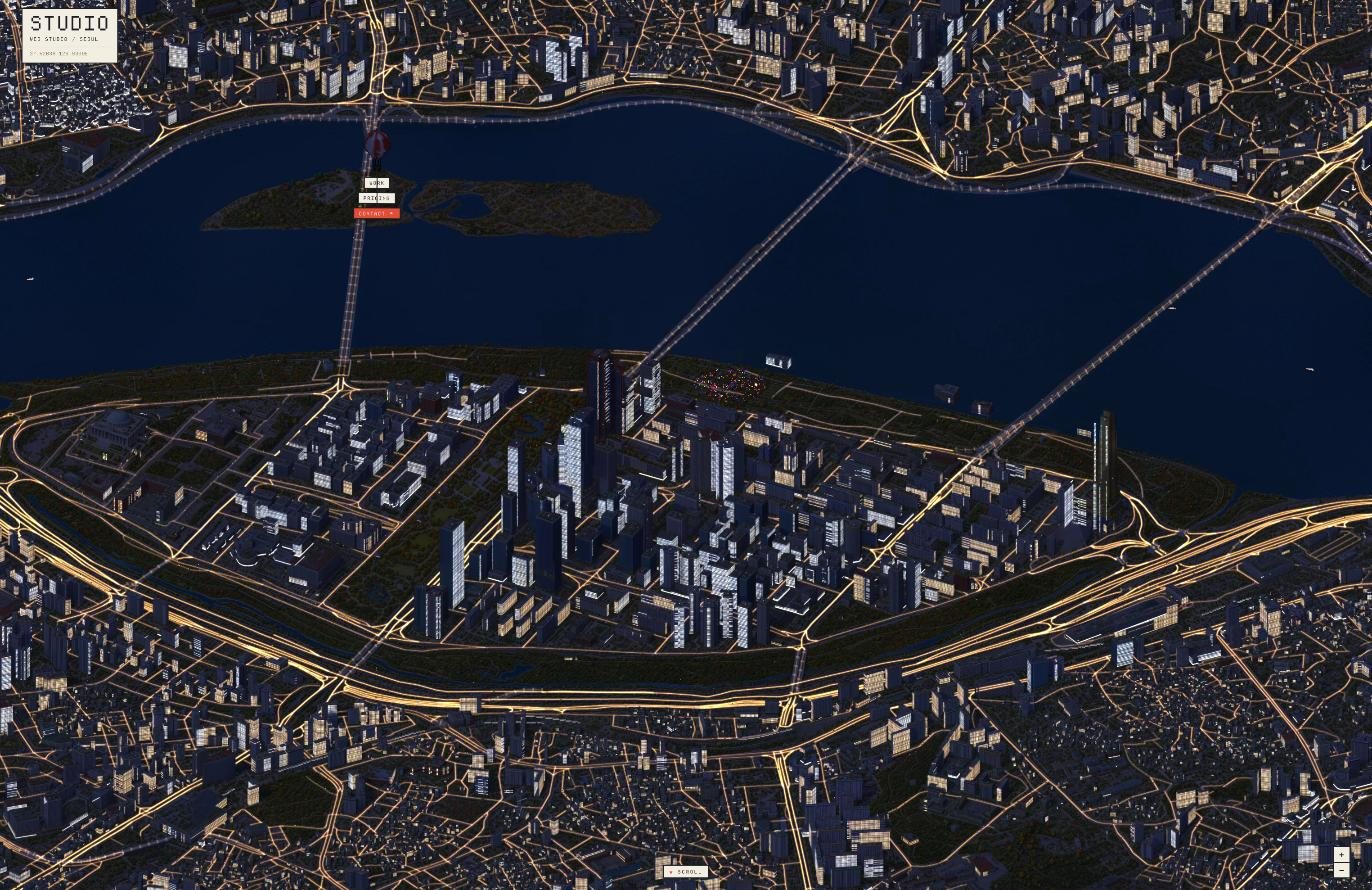
밤 그림을 다시 생성하면 비용이 두 배다. 대신 그림을 어둡게 물들이고, 켜지는 것만 따로 계산해 더한다(lights.py).
- 엔진 건물(실제 높이)을 같은 카메라로 투영하고, 화면에서 가장 아래 땅점 기준으로 먼 것부터 그린다. 가까운 건물의 지붕이 뒤의 벽을 가린다.
- 카메라 쪽을 향한 벽에만 창문을 낸다. 벽 방향 벡터를
AX·e[0] + AZ·e[1]로 화면에 옮겨 미터당 px를 구하고, 종류별 표(켜짐 비율, 색, 층고, 창 폭)로 격자를 깐다. 아파트는 켜짐 0.45·따뜻한 노랑·층고 2.9m·창 폭 3.4m 같은 식이다. - 층 단위로 30%를 통째로 끈다(
hsh(b, floor) < .3). 난수는 건물 번호와 층 번호의 결정적 해시라 다시 돌려도 같다. - 도로는 밝은 심 + 따뜻한 번짐, 다리는 약 25m 간격 호박색 가로등 점, 120m 넘는 타워엔 꼭대기 불.
- 브라우저에서는 그림에 밤 색(0.3, 0.34, 0.52)을 곱하고, 불빛 피라미드가 있는 그림은 한 번 더 어둡게(0.66, 0.7, 0.77) 한 뒤 불빛 타일 × 1.15를 더한다.
9,704칸을 로컬에서 6분, 0원에 계산했다(439MB). 첫 결과는 오피스가 모눈종이처럼 고르게 하얬고 다리가 흰 굵은 선이었다. 꺼진 층과 밝기 차이, 덜 파란 흰빛, 다리 가로등 점으로 풀었다.
남산타워에서는 다른 함정이 나왔다. 모델이 타워를 사무실 상자 위에 얹어 그려서 다시 그렸는데, 야경은 여전히 옛 상자 자리에 창문을 켰다. 그림을 고치면 그 그림에서 계산한 층도 같이 고쳐야 한다. 타워 자리의 엔진 건물 8채는 창문을 끄고, 그림 자체를 비추게 했다. 축 근처의 흰·회색 픽셀만 골라(주황 단풍은 제외) 아래는 푸른 흰빛에서 위로 라일락, 높이 53% 지점에 전망대 링, 꼭대기에 빨간 항공등. 궁궐도 상자 대신 그림을 은은하게 비추되, 녹지는 어둡게 남겼다. 축소 레벨을 만들 때 밝기를 단계마다 1.25배씩 올렸더니 멀리서 주황 덩어리가 돼서, 네 칸 중 가장 밝은 값을 넘지 않게 바꿨다.
8. 브라우저 타일 로더
그림은 768px WebP 타일 피라미드(z0~8)다. 타일 원본은 약 2.0GB, 불빛 439MB이고, 정적 스토리지에 파일 22,186개로 올렸다. engine/paint.mjs가 매 프레임 보이는 타일을 화면 사각형으로 그린다.
레벨은 기기 픽셀 기준으로 고른다.
const zf = M.maxZoom - Math.log2(1 / (k * DPR));   // k = 최대 레벨 캔버스 px당 화면 px
const z = Math.max(0, Math.min(M.maxZoom, Math.ceil(zf - .25))), zb = Math.max(0, z - 2);
v1은 자기 텍스처가 올 때까지 안 그리고, 밑에 3단계 아래(8배 흐린) 고정 백스톱만 깔았다. 그래서 이동하면 흐린 사각형이 1~2초 보이고, 줌인하면 이미 받아 둔 중간 해상도를 안 썼고, 밤에는 불빛이 늦게 와서 어두운 사각형이 생겼다. v2는 이렇게 바꿨다.
- 아직 안 온 칸은 이미 보여준 가장 가까운 부모 레벨, 줌아웃이면 자식 레벨로 덮는다. 백스톱은 두 단계 거친 레벨(z−2, 몇 장)로 제일 먼저 받는다.
- 요청은 큐다. 화면 중앙에서 가까운 순, 동시 8개. 이번 프레임에 다시 요청되지 않은 대기 작업은 버리고, 시작했는데 20프레임 넘게 안 온 것은
AbortController로 끊는다. fetch → createImageBitmap으로 메인 스레드 밖에서 디코드하고, GPU 업로드는 프레임당 3장까지만. 한꺼번에 도착해도 프레임이 튀지 않는다.- 새 타일은 240ms 페이드인. 밤에는 불빛 타일까지 와야 그 칸을 보여준다.
- 30프레임마다 LRU로 비운다. 예산은 데스크톱 140장.
function pump() {
  for (const j of jobs.values()) {
    const stale = j.ctl ? !j.got && frame - j.frame > 20 : j.frame !== frame;
    if (stale) { if (j.ctl) { j.dead = true; j.ctl.abort(); } jobs.delete(j.url); }
  }
  const todo = [...jobs.values()].filter(j => !j.ctl).sort((a, b) => a.prio - b.prio);
  for (const j of todo) { if (active >= MAX_NET) break; start(j); }
}
실제 타일로 빌드한 로컬에서 확인했다. 새 위치 첫 로딩은 4초 안에 밤 그림까지 완성, 이동은 1초 안에 채워짐, 흐린 경계 없음, 줌인 즉시 선명. 엔진이 서는 동안 보여 주는 2D 미리보기도 고정 1.2초가 아니라 타일이 화면의 95%를 덮을 때까지(최대 6초) 유지하게 바꿨다.
물 흐름. 같은 셰이더에서 엔진 토지이용 지도(물)를 다시 읽는다. 캔버스 아핀의 역행렬로 타일 픽셀을 세계 좌표로 되돌려 물 여부를 보니, 파란 유리 빌딩은 건드리지 않는다. 물 위에서만 강 방향(화면 기준 약 (1, 0.22))으로 늘린 노이즈 세 겹이 서쪽으로 흐르고, 그림을 1~2px 흔든다. 멀리서는 꺼진다.
9. 렉 잡기
서울 전체를 한 번에 올리자 첫 화면까지 10~15초, 프레임 중앙값 18ms에 가끔 70~100ms가 튀었다. ?perf로 파트별 프레임 시간을 쟀다.
- 움직이는 층 계산이 평균 23ms, 최대 62ms였다. 보행자 9만 명·차 6,500대를 화면 밖까지 매 프레임 갱신하고 있었다. 화면(+여유) 안만 갱신하고, 보행자는 400m 칸 단위로 화면 칸만, 멀리서(1.6 m/px 이상)는 생략. 도로 고르기 4.2만 개 순차 탐색을 이진 탐색으로. 23ms → 2~5ms.
- GPU는 그림 밑에 가려 안 보이는 3D 도시를 매 프레임 그리고 있었다. 삼각형 2,690만, 인스턴스 170만(나무 45만 그루가 910만 삼각형, 주차차 24만 대 등). three.js는 InstancedMesh의 모든 인스턴스를 매번 그린다.
engine/cull.mjs는 인스턴스를 400m 땅 칸으로 미리 정렬해 두고, 화면의 칸 범위가 바뀔 때만 보이는 칸의 행렬을 버퍼 앞으로 복사한 뒤mesh.count를 줄인다.
for (let cx = cx0; cx <= cx1; cx++) for (let cz = cz0; cz <= cz1; cz++) {
  const r = range.get(`${cx},${cz}`); if (!r) continue;
  dm.set(SM.subarray(r[0] * 16, r[1] * 16), k * 16);   // 칸 하나 = 연속 구간 하나
  k += r[1] - r[0];
}
mesh.count = k;   // + addUpdateRange(0, k * 16)로 바뀐 앞부분만 업로드
같은 여의도 화면에서 인스턴스 170만 → 약 5천, 삼각형 2,690만 → 680만, JS 메모리(안정 후) 2.2GB → 0.75GB, 46 → 73fps.
- 그림이 있으면 골목 도로의 3D 면(차선·보도)은 아예 만들지 않는다. 데이터 준비 11.2초 → 7.0초, 삼각형 680만 → 420만.
- 도로 따라 주차차·보행자·가로수 자리를 고르는 계산이 매번 브라우저에서 5.2초 걸렸다.
tools/bake-streets.mjs가 엔진 워커 코드를 Node에서 그대로 돌려(같은 코드, 같은 해시) 주차차 240,148·보행자 89,937·가로수 115,409 자리를 6.2MB로 굽는다. 도로선·지형·구역의 지문(fingerprint)이 데이터와 다르면 예전처럼 직접 계산한다. 처음엔 파일 크기로 일치를 봤는데, 높이만 바뀐 재빌드는 크기가 같아서 지문으로 바꿨다. 도로 단계 5.2초 → 0.06~0.12초, 워커 전체 약 7초 → 1.25~1.5초. - 도시가 서는 동안 2D 캔버스로 그림부터 그린다. 카메라 아핀만 있으면 되니 첫 그림이 2초 안에 나온다.
10. 모바일 GPU
화질. 렌더러 pixelRatio가 1이라 레티나와 폰에서 1배로 그려 늘리고 있었다. 최종 화면과 그림 레이어는 기기 해상도(최대 2배)로, 엔진 본 패스는 픽셀 룩을 위해 그대로 저해상도로 뒀다. 대신 6K 모니터에서 2배면 한 프레임이 24Mpx라 밤 화면이 검게 나온 적이 있어서 출력 픽셀을 약 8.3Mpx로 묶었다.
DPR = Math.max(1, Math.min(2, devicePixelRatio || 1, Math.sqrt(8.3e6 / (w * h))));
깜빡임. 아이폰 화면 녹화를 프레임 단위로 보니, 밤에 그림 타일이 네모 단위로 깜빡이다 그림이 통째로 사라지고 엔진만 남았다. GPU 메모리 초과로 판단했다. 원인은 세 가지가 겹친 것이었다. 2배 해상도라 더 고운 레벨을 받아서 캐시가 빨리 찼고, 밤 불빛 텍스처가 예산 계산에서 빠져 있었고, 밉맵이 텍스처마다 약 33%를 더 먹었다.
768² RGBA8 타일 한 장은 약 2.4MB, 밉맵을 붙이면 약 3.1MB다(단순 계산, 실측 아님). 수정 전 폰 예산 72장은 그림만 약 227MB였고 밤에는 불빛이 그만큼 더 붙을 수 있었다. 수정 후는 불빛까지 합쳐 56장, 밉맵 없이 약 132MB다.
const COARSE = matchMedia('(pointer: coarse)').matches || new URLSearchParams(location.search).has('coarse');
const MAX_PYR = COARSE ? 56 : 140;
// 업로드: 폰은 밉맵 없음 (레벨을 기기 픽셀로 고르니 크게 줄일 일이 없다)
tx.minFilter = COARSE ? THREE.LinearFilter : THREE.LinearMipmapLinearFilter; tx.generateMipmaps = !COARSE;
검증은 데스크톱에서 ?coarse로 폰 예산을 흉내 내고 밤 화면을 40스텝 패닝하며 덮힘 비율(cover)을 기록했다. 패닝 중 0.8~1, 멈추면 1. 배포된 코드도 확인했다. 아이폰 실기기에서는 아직 다시 확인하지 못했다.
열기구 끌기. 메뉴 열기구는 스프링으로 화면 자리를 따라간다(평소 k=9, 감쇠 4.2, 잡았을 때 k=60, 감쇠 11, 지도가 밀리면 바람처럼 끌려감). 폰에서는 손가락 끌기가 처음 몇 px만 따라오고 멈췄다. 지도 영역이 touch-action: pan-y로 세로 스와이프를 페이지 스크롤에 넘기고 있어서 브라우저가 포인터를 취소한 것이다. 풍선 위에 투명한 잡기 영역을 따라다니게 해서 풀었다.
11. 실제 지하철 위치: 하루 1,000번으로 모두에게 보여주기
처음 지하철은 가짜였다. 지상으로 드러난 선로 구간을 이어 붙이고, 2.6km마다 열차 한 대를 놓고 16~22m/s 사이 랜덤 속도로 왕복시켰다. 지하로 들어가는 구간에서는 숨겼다. 출시 직전에 이걸 실제 운행 데이터로 바꿨다.
데이터. 서울 열린데이터광장의 실시간 열차 위치 API다. 좌표를 주지 않고 "어느 열차가 어느 역에 진입/도착/출발했다"를 준다. 열차 번호, 역 이름, 상·하행(2호선은 내·외선), 상태, 수신 시각이 온다. 키 하나로 하루 1,000번까지 부를 수 있고, 약관상 키를 남에게 공개하거나 공유하면 안 된다.
어느 노선을 받을까. 지도에 지상 선로가 보이는 노선부터 셌다. 노선별 지상 길이는 1호선 계열 195km, 경의중앙 99km, 2호선 31km, 경춘 22km, 3호선 12km, 공항철도 9km였다. 이 중 1·2·3호선과 경의중앙선, 4개만 실시간으로 받는다. 나머지는 가짜 열차로 남겼다.
구조: 방문자는 서울시를 부르지 않는다.
방문자 브라우저 ──(5분마다)──▶ /api/subway  (Vercel 함수 + CDN 캐시 10분)
                                   │  10분에 한 번만
                                   ▼
                          서울시 실시간 열차 위치 API (노선 4개 = 4번)
키는 Vercel 환경변수에만 있다. 함수는 응답에 s-maxage=600을 붙여서 CDN이 10분 동안 같은 사본을 나눠준다. 그래서 방문자가 몇 명이든 서울시 API는 한 지역에서 10분에 4번, 하루 576번만 불린다.
// api/subway.js (요약)
res.setHeader('cache-control', 'public, max-age=60, s-maxage=600, stale-while-revalidate=300');
한도에 걸리거나 서울시 서버가 빈 응답을 주면 함수는 직전의 정상 데이터를 계속 내준다. 그것마저 없으면 화면은 그 노선만 가짜 열차로 되돌린다. 열차가 통째로 사라지는 일은 없게 했다. CDN 사본은 지역마다 따로 생긴다. 그래서 해외 트래픽이 붙으면 지역 수만큼 호출이 늘어나는데, 이건 열린데이터광장 '활용사례' 등록으로 한도를 풀 계획이다.
역 이름을 지도 위 점으로. API는 역 이름만 준다. 처음에는 Overpass API에서 역 좌표를 받으려 했는데 두 번 다 타임아웃이 났다. 그래서 지도를 만들 때 쓴 OSM 추출 파일(pbf)에서 역 노드 524개를 직접 뽑았다(tools/extract-stations.cjs). 투영은 지도와 같은 식을 쓴다.
const proj = (lat, lon) => [(lon - LON0) * KX, -(lat - LAT0) * KZ]; // 지도와 같은 원점·축척
"신촌"처럼 이름이 같은 역이 여러 개면, 그 노선의 지상 선로에 가장 가까운 후보를 고른다. 선로에서 220m 넘게 떨어진 역은 지하 역으로 보고, 거기 있는 열차는 그리지 않는다. 터널 속에 있는 것으로 치는 거다.
상행이 어느 쪽인가. 데이터의 상·하행이 화면의 선로 방향 중 어느 쪽인지는 아무 데도 없다. 그래서 2분 간격으로 스냅샷을 두 번 찍어서(호출 8번) 역 A에서 B로 움직인 열차 97편을 모았다. "이 노선의 이 방향은 이 근처에서 이쪽으로 간다"는 표본이 된다. 실행 중에는 열차가 있는 역에서 가장 가까운 같은 노선·같은 방향 표본을 찾고, 그 이동 방향과 선로 접선을 내적해서 부호를 정한다.
// engine/realtrains.mjs (요약)
const dir = Math.sign(tangentAt(station).dot(nearestLearntMove(line, updn, station)));
const off = { 0: -250, 1: 0, 2: 30, 3: -800 }[status];   // 진입, 도착, 출발, 전역 출발
const d = station.d + dir * (off + Math.min(7000, secondsSinceReport * 11));
10분 사이를 메우기. 데이터는 최대 10분 전 것이다. 받은 시각부터 지하철 평균 속도(11m/s, 정차 포함)로 계속 달리게 했다. 새 데이터가 오면 같은 열차 번호끼리 6초에 걸쳐 새 위치로 미끄러지게 해서 순간이동하지 않는다. 실시간 열차가 들어오면, 그 노선의 가짜 열차 자리(instanced mesh 슬롯)를 비우고 실제 열차로 채운다. 남는 슬롯은 화면 밖(y=-999)으로 치운다.
배포에서 막힌 것. 정적 사이트 설정(outputDirectory: ".", 빈 빌드 명령)에서는 api/ 폴더를 넣어도 함수가 만들어지지 않고 404가 났다. vercel.json에 functions를 명시하자 살아났다.
결과와 한계. 배포 직후 기준으로 운행 중인 열차는 155편이었고, 그중 지상에 있어서 그려진 건 45편이었다. 예전 가짜 열차는 약 140편이 고르게 흩어져 있었다. 진짜 데이터로 바꾸자 오히려 지도가 휑해졌다. 대부분 열차가 그 순간 지하에 있기 때문이다. 정직하게 보여주는 것과 북적여 보이는 것 사이에서 아직 고르는 중이다. 붙이고 나서 바로 버그 두 개가 나왔다. - 처음에 진행 상한을 3km로 뒀더니, 10분 데이터 사이에 열차가 선로 한가운데서 멈춰 섰다. - 선로 끝을 넘어간 열차들이 끝자락에 겹쳐 서 있었다.
상한을 7km로 늘리고, 선로 밖으로 나간 열차는 숨기는 걸로 고쳤다.
정확히 말하면 완전한 실시간은 아니다. 데이터는 최대 10분 전 것이고, 그 사이는 예측으로 움직인다. 그래서 소개 문구도 "실시간 지하철"이 아니라 "실제 운행 데이터로 움직이는 지하철"로 쓴다.
숫자로 보는 제작
| 항목 | 값 |
|---|---|
| 서울 칸 수 | 첫 완성 6,394칸(603km²), 범위·지형 보정 후 6,470칸 |
| 칸 규격 | 1024px, 0.3 m/px, 768px 간격(겹침 256px), 경계 섞기 96px |
| 학습 데이터 | 검사 통과 33쌍 (엔진 렌더 ↔ 그림) |
| 채택 모델 | FLUX.2 klein base 4B 편집 LoRA, rank 64(alpha 32), 1,500단계, lr 1e-4, bf16 |
| 학습 속도 | 맥북 57~77초/단계 → Kaggle T4 27초 → A100 2.41초 |
| 추론 | 8스텝·guidance 1, A100 칸당 4.1초(시험) / 4.9초(본 변환) |
| 서울 전체 변환 | A100 10대 동시, 51분, 오류 0 |
| GPU 생성비 | 첫 완성까지 Modal 누적 약 $36(무료 크레딧 $30 포함), 10-23 기준 누적 $44.98 |
| 건물 | 약 58.5만 채, 공식 높이 20.4만 채 |
| 다시 그린 곳 | 패치 122장 (랜드마크·궁궐·성수 사옥·건축상 건물·주차장, 한강 다리 24곳 37장 포함) |
| 야경 | 9,704칸, 로컬 6분, 0원 |
| 타일 | 768px WebP z0~8, 약 2.0GB + 불빛 439MB, 파일 22,186개 |
| 렌더 최적화 | 인스턴스 170만 → 약 5천, 삼각형 2,690만 → 420만, 46 → 73fps, JS 메모리 2.2GB → 0.75GB |
| 로딩 | 워커 약 7초 → 1.25~1.5초, 첫 그림 2초 안 |
| GPU 텍스처 예산 | 데스크톱 140장, 폰 72 → 56장(불빛 포함, 밉맵 없음) |
| 캐릭터 | 한국 고전 캐릭터 36종 |
실패에서 배운 것
- 생성 전에 곱셈부터. 칸 수 × 장당 비용 × 한도 × 일수. 이걸 안 해서 이틀을 잃었다.
- 모델의 실수 중 상당수는 데이터의 실수다. 빈 땅의 숲, 빌라의 고층화, 63빌딩의 회색 판. 그림을 고치기 전에 입력부터 의심할 것.
- 같은 단계에서 반복해서 죽으면 설정이 아니라 입력 크기다. 도구 코드를 직접 읽는 게 가장 빨랐다.
- 학습 도구의 "상태"를 믿지 말 것. 불러온 LoRA의 단계 수를 무시하고 다시 학습했고, 로컬을 꺼도 원격 앱은 돌고 있었다.
- 예쁜 조각보다 이어진 전체. 칸마다 잘 그린 것보다 한 손으로 이어 그린 것이 이긴다. 긴 구조물은 한 장에 넣어 다시 그린다.
- 같은 카메라를 지키면 모든 게 공짜가 된다. 자동 검사, 정합, 야경, 가림, 클릭.
- 파생 데이터는 원본을 따라 고친다. 그림을 고치면 그 그림에서 계산한 야경도 다시 계산해야 한다.
- GPU 예산엔 모든 텍스처를 넣는다. 빠진 하나(불빛)와 숨은 33%(밉맵)가 폰을 죽였다.
- "과하다"는 신호를 일찍 받을 것. 행사 효과는 "완전 하이라이트"로 키웠다가 "너무 과해, 그 행사 특성에 맞춰야지"로 돌아왔다. 구름도 세 번 갈아엎었다.
- 어울리게 하려면 같은 파이프라인 안에 넣는다. 위에 붙인 것은 아무리 다듬어도 스티커다.
다음 계획
- 타일 캐시 늘리기. 출시 직전 타일을 r2.dev(속도 제한, 캐시 없음)에서 커스텀 도메인 + Cloudflare 캐시로 옮겼다. 지금은 하루 캐시라 타일을 바꾸면 하루 안에 반영된다. 그림이 굳으면 버전 폴더 + 1년 캐시로 바꾼다.
- 지붕 캐릭터 공개: 지도에 숨은 알을 찾으면 캐릭터를 24시간 올릴 수 있는 구조. 남용 방지 규칙은 설계 중.
- 다시 그린 구역의 밤 불빛 재계산, 실기기 모바일 점검.
- 도시 데이터 칸 나눠 받기(첫 다운로드 57.6MB 줄이기).
- 접속이 많은 동네를 조금 붐비게 하는 등 "말 없는 반응". 지도 위 글자·채팅은 넣지 않는다.
데이터 출처
-
서울특별시 공공데이터(열린데이터광장, 실시간 지하철 위치)
-
© OpenStreetMap contributors, Open Database License(ODbL)
- Overture Maps Foundation 건물 테마(ODbL). 출처에 OpenStreetMap, Microsoft Global ML Building Footprints(ODbL), Google Open Buildings·Esri Community Maps·Qian Shi 외 동아시아 건물 데이터(Zenodo 8174931)(CC BY 4.0) 포함
- 국토교통부 GIS건물통합정보(건축물대장 속성 통합), CC BY
- 지형: AWS Open Data Terrain Tiles(Terrarium, Mapzen Joerd, SRTM 등 공공 고도 데이터)
- 위성사진(Esri World Imagery)은 검토용 대조로만 썼고 모델 입력에는 쓰지 않았다.
- 모델: FLUX.2 klein 4B (Apache 2.0), 학습 도구 ai-toolkit (MIT, Ostris)
- 렌더링: three.js (라이선스 파일을 빌드에 동봉)
- 영감: isometric.nyc by Andy Coenen. HypeSeoul은 독립 프로젝트다.